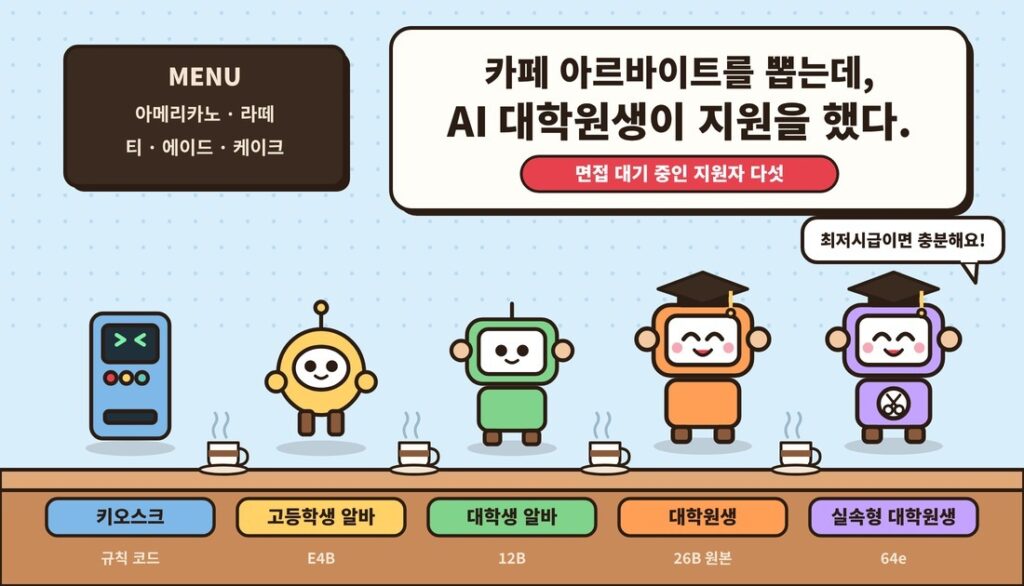
배경 상황
안녕하세요 동네 카페 사장입니다.(가정입니다. Magic If)
카페 아르바이트 공고를 냈습니다. 하는 일은 단순합니다.
손님 요청을 잘 파악하고, 포스기에 정확히 찍고, 애매하면 한 번 더 묻는 것.
그런데 지원서 더미 속에 눈에 띄는 이력서가 하나 있습니다.
AI 대학원생! 아니 이런 친구가 아르바이트를?
머리가 좋으니 일도 잘할 가능성이 높아 보이는데, 걸리는 게 하나 있습니다.
나는 최저시급밖에 못 주는데, 괜찮을까??
이 지원자는 월급을 시급이 아니라 메모리로 받는다고 가정해봅니다.(메모리 용량, 연산 장치 같은 컴퓨터 자원)
그리고 그 액수는 웬만한 노트북 한 대를 통째로 달라는 수준입니다.
– 이 글은 그 고민을 실제로 실험해 본 기록입니다.
카페 알바를 로봇으로 변경해보겠습니다.
카페 알바 로봇의 자리를 두고 AI 지원자 다섯이 면접을 봤습니다.
그리고 그중 한 명은, 같은 대학원생인데 카페 알바를 하려고 나머지 지식은 까먹었다며…
그래서 최저시급만 받아도 상관없다고 하는데, 이거 뭔가 뽑고 싶은 생각이 드는데요!?
한눈에 보기
- 26B 모델에서 카페 일에 덜 쓰이는 ‘전문가’를 절반 덜어낸 64e는, 일반 지식은 크게 잃었지만 실제 손님 주문 처리는 원본과 거의 같았습니다.
- 64e는 노트북 내장 그래픽 처리 장치(GPU, Graphics Processing Unit)에 올라가, 같은 노트북의 12B보다 빠르고 실전 점수도 높았습니다.
- 다만 너무 많이 덜어내면 무너졌고, 그 사실은 AI가 만든 시험이 아니라 사람이 쓴 시험에서만 드러났습니다.
1. 왜 이 실험이 필요했나 (시키는 것만 잘 하면 되겠네?)
AI 에이전트가 하는 일의 상당수는 말을 알아듣고, 정해진 도구를 누르는 것입니다.
카페로 옮기면 “아아 큰 걸로 두 잔이요”를 듣고 주문_추가(아이스 아메리카노, 라지, 2잔) 버튼을 누르는 일이죠. 카페 일에 세계사 지식이나 미적분은 필요 없습니다.
카페가서 손님이 “자동차 바퀴는 어떻게 갈아요?” 그러진 않으니까요. (물론 저도 모릅니다.)
문제는, 이런 일을 잘하는 큰 거대 언어 모델(LLM, Large Language Model)은 쓰지도 않을 지식까지 통째로 메모리에 올려야 한다는 점입니다. 그래서 고성능 GPU가 없는 노트북이나, 작은 로봇 안에는 들어가지 않습니다. 보안 때문에 외부 AI 서비스를 쓸 수 없는 온프레미스 환경이라면 더 절실한 문제입니다.
그래서 질문을 하나로 좁혔습니다.
큰 모델에서 일에 필요 없는 부분만 덜어내면, 노트북에 올라가면서도 일은 계속 잘할까?
“카페 로봇은 우리 카페와 관련된 내용만 알면 충분하지 않을까? 카페 일만 잘하면 되잖아!?“
“다른 업무를 시킬, 보수를 지급할 여력은 없는데…“
가설은 두 개였습니다.
- 가설 1. 비슷한 메모리라면, 큰 모델을 덜어낸 쪽이 처음부터 작은 모델보다 일을 잘한다.
– (큰 모델을 깎아 쓰는 게, 처음부터 작은 모델을 쓰는 것보다 나을 거다!) - 가설 2. 덜어내면 일반 지식은 떨어지지만, 맡은 일은 잘할 거다.
실험 범위는 로봇 전체가 아니라 손님 말을 도구 호출로 바꾸는 언어 두뇌뿐입니다. 장비는 노트북 한 대(메모리 32GB, 인텔 내장 GPU)이고, 유료 클라우드 GPU는 쓰지 않았습니다.
2. 지원자 소개
지원자는 모두 구글의 공개 모델 젬마4(Gemma 4) 가족입니다. 같은 회사가 같은 방식으로 크기만 달리 만든 모델들이라, 공정하게 비교하기 좋습니다. 이름의 B는 모델 안의 숫자(매개변수)가 10억(Billion) 개 단위라는 뜻으로, 26B는 매개변수가 약 260억 개입니다. 여기에 AI가 아닌 지원자도 한 명 넣었습니다.
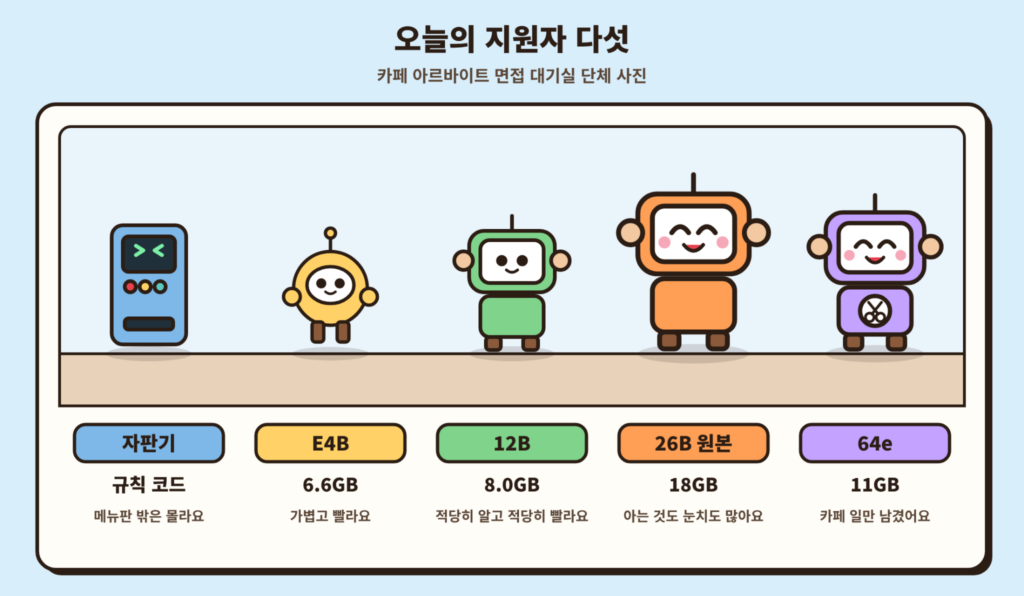
| 지원자 | 정체 | 자기소개 한 줄 | 크기 |
| 자판기 | 규칙 기반 코드 | 메뉴판에 있는 말이라면 0.002초 만에 처리합니다. 메뉴판 밖의 말은 모릅니다. | – |
| E4B | 젬마4 소형 모델 | 가볍고 빠릅니다. 웬만한 노트북 어디서든 일할 수 있어요. | 6.6GB |
| 12B | 젬마4 중형 모델 | 노트북용으로 나온 중간 체급입니다. 적당히 알고, 적당히 빠릅니다. | 8.0GB |
| 26B 원본 | 젬마4 전문가 혼합 모델 | 아는 것도 많고 눈치도 빠릅니다. 다만 방이 넓고 18GB는 있어야 합니다. | 18GB |
| 64e | 26B에서 전문가 절반을 덜어낸 모델 | 카페 일에 안 쓰는 지식을 절반 덜어냈습니다. 방은 적당히 11GB면 됩니다. | 11GB |
같은 방식으로 덜 덜어낸 98e와 더 많이 덜어낸 48e도 비교용으로 함께 면접을 봤습니다. 마지막 지원자 64e가 이 글의 주인공입니다. 대학원생이 지식을 어떻게 까먹었는지부터 보겠습니다.
3. 대학원생의 머리를 어떻게 덜어냈나
3-1. 머릿속에 바리스타가 128명 (젬마4 구조)
언어 모델은 같은 구조의 층(layer)을 수십 개 쌓은 것입니다. 층 하나는 보통 두 부분으로 되어 있습니다. 문장 속 단어끼리 정보를 주고받는 어텐션(attention), 그리고 각 단어를 깊이 가공하는 피드포워드 신경망(FFN, Feed-Forward Network)입니다. 모델이 배운 지식의 상당 부분이 이 FFN에 들어 있습니다.
젬마4 26B는 여기에 한 가지 장치를 더 씁니다. 전문가 혼합(MoE, Mixture of Experts) 구조입니다. 큰 FFN 하나 대신 작은 FFN 128개를 나란히 두고, 단어(토큰)가 들어올 때마다 라우터(router)가 그중 8개만 골라 일을 시킵니다. 이 작은 FFN 하나하나를 ‘전문가(expert)’라고 부릅니다.
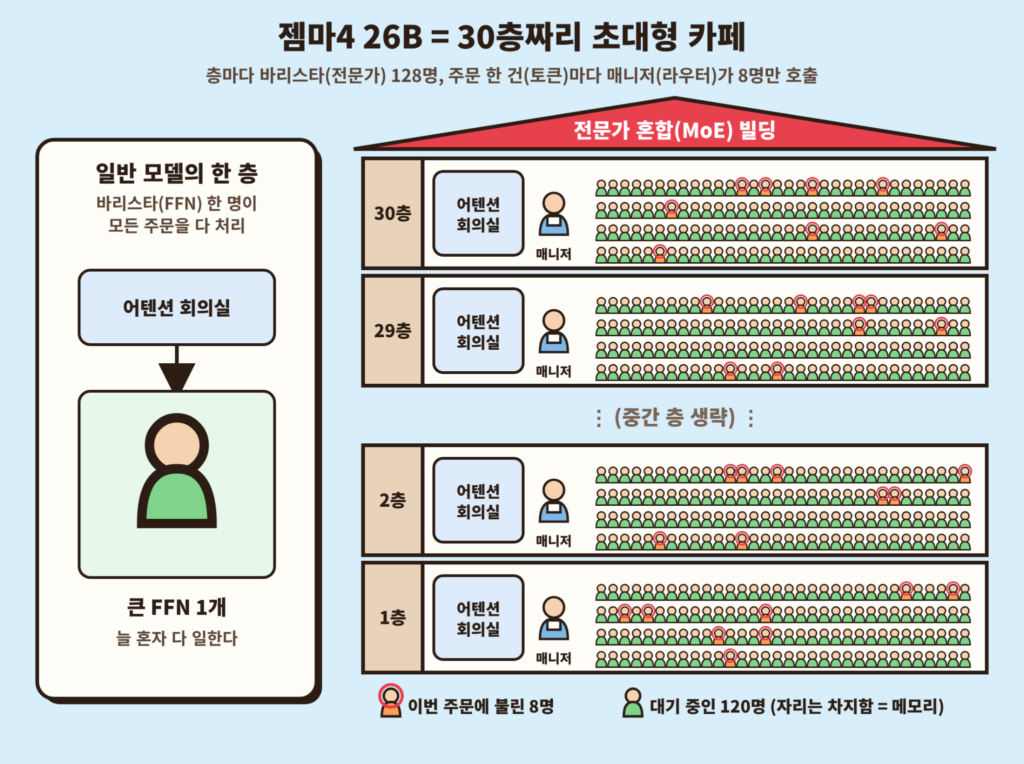
카페로 치면, 정말 초대형 카페인데 매니저가 전략을 지시해서 효율적으로 운용하는 겁니다.
주방에 바리스타가 128명 있고 매니저가 주문마다 8명만 불러 일을 시키는 가게입니다. 그 결과 이런 특징이 생깁니다.
- 일하는 사람은 8명뿐이라 계산이 가볍다 → 26B인데도 토큰당 실제 계산은 약 3.8B 수준
- 하지만 128명 전원의 자리(메모리)는 마련해 둬야 한다 → 30개 층 × 128명 = 3,840명, 모델 전체의 88.5%가 전문가
실제로 노트북에서 재 보니, 26B 원본이 12B보다 빨랐습니다(중앙 처리 장치(CPU, Central Processing Unit) 기준 초당 15.0토큰 vs 9.8토큰). 대신 메모리는 감당이 안 됐습니다. 4비트로 압축한 파일만 18GB라, 노트북 내장 GPU에는 아예 올라가지 않았습니다.
3-2. 카페 일을 안 하는 바리스타를 내보내기 (응 오늘 그냥 퇴근해)
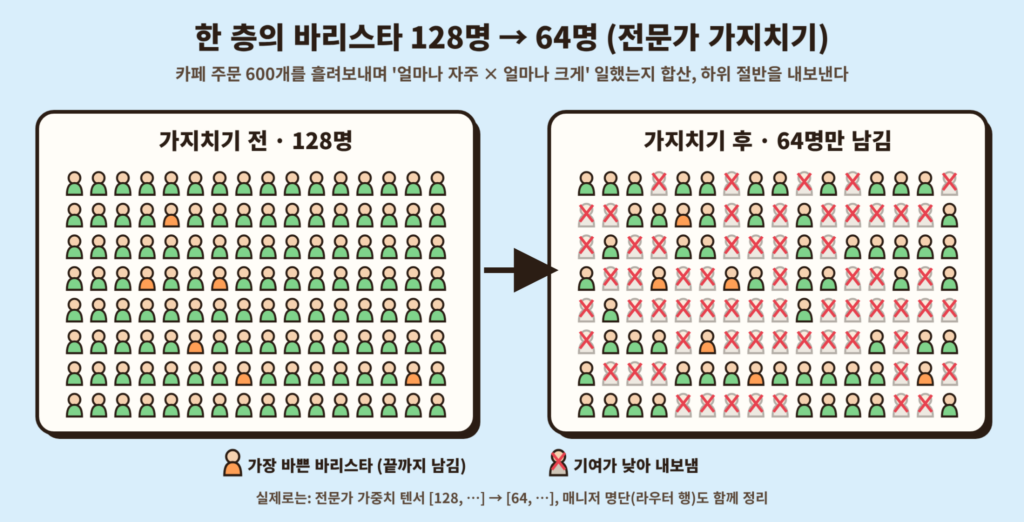
그렇다면 카페 일을 할 때 매니저가 거의 부르지 않는 바리스타는 내보내도 되지 않을까요? 이것이 전문가 가지치기(Expert Pruning)입니다.
– 오늘 일을 적게 한 자, 근무 시간을 줄일지어다.(시급제 직원이라서 이거 슬픈 소식입니다.)
방법은 세 단계입니다.
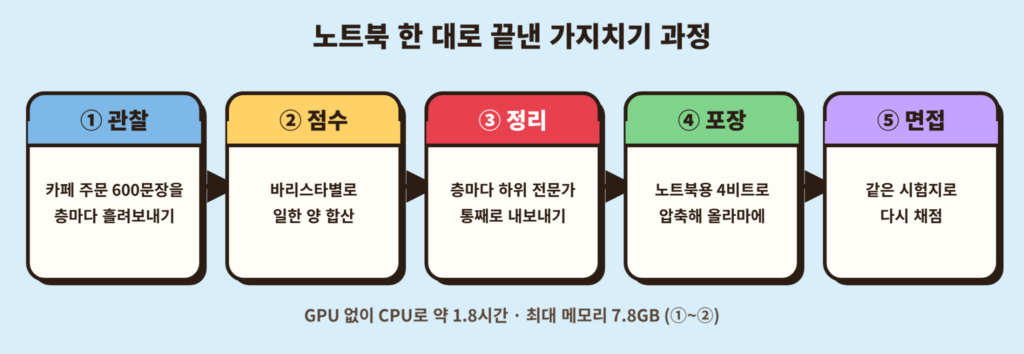
- 관찰: 카페 주문 문장 600개를 모델에 흘려보내며, 층마다 128명 각각이 얼마나 자주, 얼마나 크게 일했는지 기록합니다. 이 600문장은 시험 문제와 겹치지 않게 따로 만들었습니다.
- 점수: 기록으로 전문가마다 기여 점수를 매깁니다.
- 정리: 층마다 점수가 낮은 전문가를 통째로 지웁니다. 가중치 값을 고치는 게 아니라, 행렬에서 그 전문가의 줄을 빼고 매니저 명단에서도 이름을 지웁니다.
남길 인원은 층당 98명, 64명, 48명 세 가지로 만들었습니다. 주인공 ’64e’는 3,840명 중 정확히 절반인 1,920명을 내보낸 모델입니다.
– 죄송하지만, 주문에 필요가 없어 퇴사를 권고드립니다. (제 미래가 될 것 같기도 합니다.)
흥미로운 사실이 하나 있었습니다. 3,840명 중 카페 문장에서 한 번도 불리지 않은 전문가는 213명뿐이었습니다. 카페 담당, 역사 담당처럼 깔끔하게 나뉘어 있는 게 아니라, 대부분이 조금씩 섞여서 일하고 있었다는 뜻입니다. 그래서 절반 넘게 내보내면 카페 일에 쓰이던 손도 같이 잘려 나갈 수밖에 없습니다.
– 아 그 직원분이 퇴사하셔서 일이 돌아가긴 하는데 너무 벅차잖아요 실수도 있고!! (응 너 로봇)
3-3. 논문 방법을 그대로 따랐더니 생긴 일 (일잘러를 퇴사시킬 뻔!?)
전문가를 고르는 기준으로는 처음에 최근 논문의 REAP라는 점수를 썼습니다. 그런데 결과를 뜯어보다 이상한 점을 발견했습니다.
※ REAP(Router-weighted Expert Activation Pruning): 전문가가 불렸을 때의 라우터 가중치와 출력 크기로 중요도를 매기는 가지치기 기준입니다. (Lasby et al., 2025, 아래 참고 자료)
30개 층 중 5번째 층에 토큰의 32~70%를 혼자 처리하는 ‘바쁜 전문가’ 8명이 있었는데, 이들이 하위권 점수를 받아 모두 해고 대상에 올라 있었습니다. REAP 점수는 “불렸을 때 한 번에 얼마나 크게 일했나”의 평균이라, 얼마나 자주 불렸는지를 보지 않기 때문입니다. 한 번 한 번의 일은 작지만 쉴 새 없이 일하는 직원이 오히려 먼저 잘리는 셈입니다. (뒤에서 다 처리해주던 에이스가 갑자기 퇴출될 뻔!)
이대로 잘랐다면 그 층에서 토큰 배정의 67%가 뒤바뀌었을 겁니다. 그래서 기준을 ‘모든 토큰에서 한 일의 합’으로 바꾸고, 토큰의 30% 이상을 처리하는 전문가는 무조건 남기는 규칙을 더했습니다.
| 전공자 노트 ① 가지치기 기준과 설계 REAP 점수는 전문가 j가 선택된 토큰에 대한 평균 E[g_j · ‖f_j(x)‖]로, 선택 빈도가 빠져 있습니다. 이번 실험은 이를 전체 토큰에 대한 합 Σ g_j · ‖f_j(x)‖로 바꾸고, 모든 요청에 붙는 고정 프롬프트(시스템 지시문 + 도구 설명, 약 3,470토큰)와 요청별 토큰의 가중치 합을 50:50으로 맞췄습니다. 여기에 토큰 30% 이상을 처리하는 전문가 보호 규칙을 더해, 98명 기준 라우팅 재배정 비율이 9.6%에서 0.3%로 줄었습니다. 고정 프롬프트에서만 쓰이는 전문가가 층마다 2~22명(총 328명) 있었지만, 최종 64e에서는 그중 325명이 잘렸는데도 시험 점수가 유지됐습니다. 이들이 꼭 필요했는지는 따로 검증하지 않았습니다. GPU 없이 통계를 모은 방법: 층을 하나씩 메모리에 올리고, 600문장의 공통 접두부를 트리로 묶어 한 번만 계산했습니다(210만 토큰 → 13만 토큰). 30개 층 전체에 CPU로 약 1.8시간, 최대 메모리 7.8GB였습니다. 이후 GGUF로 변환해 원본과 같은 텐서별 4비트 형식(Q4_K_M)으로 양자화하고 올라마(Ollama)에 올렸습니다. |
4. 면접 시험 (응 오늘 하루만 먼저 다들 일해봐.)
지원자들에게는 같은 메뉴판, 같은 매장 규칙, 같은 도구 6개(담기, 고치기, 빼기, 되묻기, 직원 부르기, 주문 확정)를 주고 세 가지 시험을 봤습니다.
| 시험 | 문항 | 만든 사람 | 무엇을 보나 |
| 카페 시험 | 120 | AI 코딩 도구 | 12가지 주문 유형. 같은 주문을 말투만 바꾼 문제 포함 |
| 실전 시험 | 20 | 필자 (카페 아르바이트 경험) | 실제 손님 말. 메뉴판 밖 요청이 절반 이상 |
| 지식 시험 | 300 | 공개 벤치마크: 대규모 다분야 언어 이해 (MMLU, Massive Multitask Language Understanding)와 한국어판(KMMLU) | 일반 상식과 전공 지식 |
카페 15종 메뉴에, 매장 규칙도 실제처럼 넣었습니다. 에이드는 아이스만, 커피에 시럽은 셀프바, 디카페인·원두 선택은 불가, 손님이 대안을 말하면 되묻지 말고 그대로 진행 등입니다.
실전 시험이 핵심입니다. 카페 시험은 AI 코딩 도구가 만들었지만, 실전 시험은 카페 아르바이트 경험이 있는 필자가 실제 손님이 할 법한 말로 직접 썼습니다.
– “따뜻한 아이스 아메리카노 주세요”
– “아아에 그 아이스티 추가 되나요? 아샷추?”
– “캐리어좀 담아주실래요?”
– “라떼 반샷만요!”
같은 말들입니다. 메뉴판 밖으로 계속 튀어나가는, 지저분하지만 진짜인 문장들입니다.
| 전공자 노트 ② 채점 조건 모든 모델은 생각 모드(thinking) 끔, temperature 0, seed 42, 같은 시스템 프롬프트로 한 번씩 돌렸습니다. 도구 이름과 핵심 인자가 정답과 일치해야 정답(엄격 채점)이며, 이를 공식 점수로 씁니다. 되묻기의 이유 분류만 무시한 관대 채점도 함께 계산했습니다. 지식 시험은 KMMLU 200 + MMLU 100문항이며, 정답이 D에 쏠려 있어 “무조건 D”만 골라도 30.0%가 나옵니다. 보정 600문장과 시험 사이에는 문장·의도 단위 중복이 0건임을 확인했습니다. |
5. 결과
| 지원자 | 크기 | 카페 시험 | 실전 시험 | 일반 지식 |
| 자판기 | – | 95.0% | 55.0% | – |
| E4B | 6.6GB | 74.2% | 40.0% | 54.0% |
| 12B | 8.0GB | 90.8% | 45.0% | 64.3% |
| 26B 원본 | 18GB | 94.2% | 75.0% | 72.7% |
| 98e (전문가 23% 삭제) | 15GB | 95.0% | 70.0% | 58.3% |
| 64e (전문가 50% 삭제) | 11GB | 93.3% | 70.0% | 47.3% |
| 48e (전문가 63% 삭제) | 9.7GB | 93.3% | 50.0% | 38.3% |
5-1. 지식은 떨어지고, 일은 버텼다 (매출이 뭐지? 네! 아아 한 잔요!)
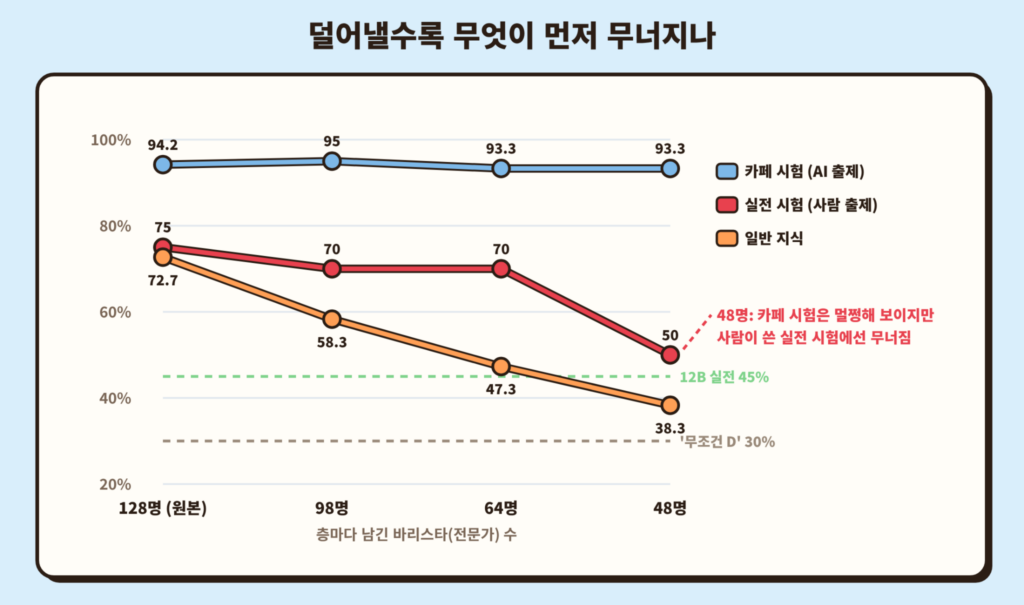
전문가를 줄일수록 일반 지식은 72.7% → 58.3% → 47.3% → 38.3%로 꾸준히 떨어졌습니다. 48명까지 줄이면 “무조건 D”(30%)와 큰 차이가 없습니다. 카페 문장으로 전문가를 골랐으니 예상한 결과입니다.
그런데 카페 시험은 세 버전 모두 93% 이상을 맞았고, 실전 시험도 64명까지는 70%로 원본(75%)과 한 문제 차이였습니다. 가설 2는 그대로 나타났습니다.
| 전공자 노트 ③ 지식 하락은 양자화 탓이 아닌가? 올라마의 원본은 비공개 중요도 행렬(imatrix)을 써서 양자화됐고, 가지치기 모델은 그것 없이 양자화했습니다. 그래서 원본을 imatrix 없이 똑같이 양자화한 대조군을 따로 만들었습니다. 대조군은 카페 94.2%, 실전 75.0%, 지식 73.7%로 원본과 같았습니다. 지식 하락은 가지치기에서 온 것입니다 |
5-2. 64e vs 12B, 같은 노트북에서 붙여 보니
가설 1의 진짜 상대는 12B입니다. 둘 다 같은 노트북 내장 GPU에 올려 같은 조건으로 재 봤습니다.
| 같은 노트북 내장 GPU | 12B | 64e |
| 주문 1건 응답 (중앙값) | 3.33초 | 2.55초 |
| 가장 느린 주문 | 12.1초 | 8.5초 |
| 생성 속도 | 초당 15.6토큰 | 초당 20.4토큰 |
| 실행 중 메모리 | 13.0GB | 15.0GB |
| 실전 시험 | 45% | 70% |
| 카페 시험 | 90.8% | 93.3% |
| 일반 지식 | 64.3% | 47.3% |
64e는 더 빠르고, 실전에서 더 정확하면서, 실행 메모리는 2GB만 더 썼습니다. 파일 크기(11GB vs 8GB)로는 차이가 커 보이지만, 12B는 토큰마다 12B 전부를 계산하는 반면 64e는 약 3.8B만 계산하기 때문입니다. 원본 26B는 이 내장 GPU에 아예 올라가지 못했습니다.(저사양 노트북 슬픔)
다만 정직하게 덧붙이면, 실전 시험은 20문제뿐이라 “64e가 12B보다 확실히 낫다”고 통계적으로 단정할 수는 없습니다. 그래도 20문제 중 12B만 맞히고 64e가 틀린 문제는 하나도 없었습니다.
| 전공자 노트 ④ 통계와 관대 채점 실전 20문항 맥니마 정확 검정(McNemar’s exact test) 결과, 64e vs 12B는 엄격 채점 p=0.062(64e만 정답 5 / 12B만 정답 0), 관대 채점 p=0.250입니다. 64e vs 원본은 p=1.000으로 구분되지 않습니다. 관대 채점으로 점수가 오른 문항(5건)은 모두 작은 모델(E4B·12B·48e)이 ‘메뉴에 없음’이나 ‘애매함’을 ‘불가능’으로 분류한 경우였습니다. 원본·98e·64e는 이런 실수가 없었습니다. 작은 모델일수록 거절하는 이유를 세밀하게 구분하지 못한다는 신호로 읽을 수 있습니다. |
5-3. 면접장 장면
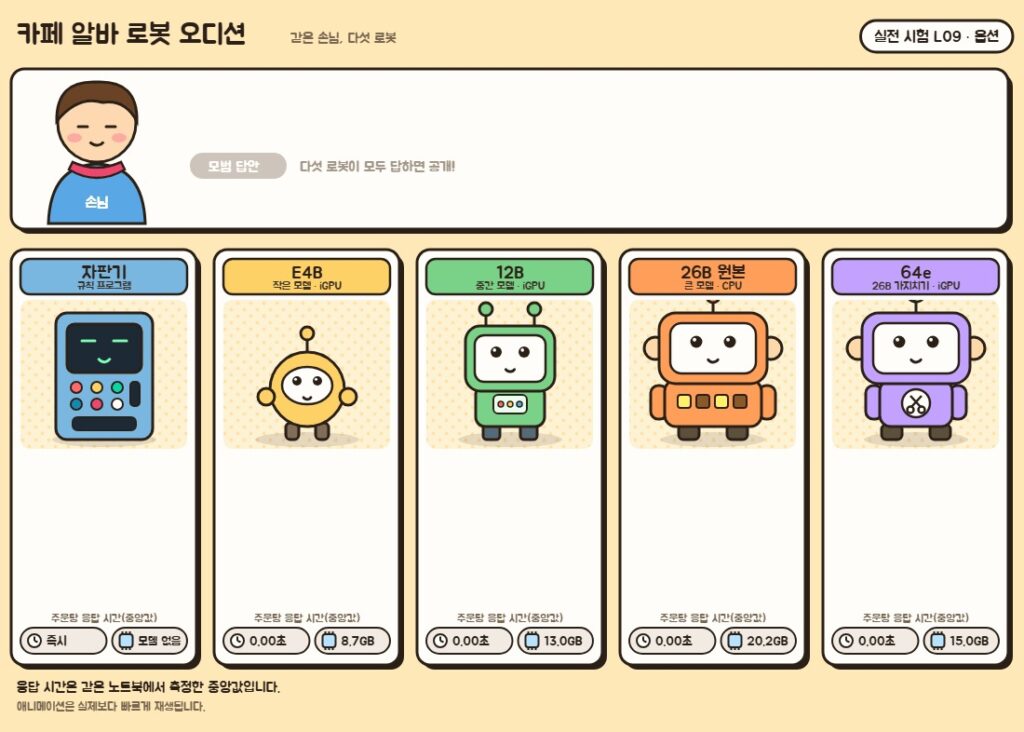
카페에서 “반샷만”은 반 샷만 넣어 달라는 뜻입니다. 다섯 지원자 중 자판기, E4B, 12B는 모두 ‘샷 반 개 추가’로 알아들었고, 26B 원본과 64e만 ‘반 샷 빼기’로 정확히 알아들었습니다.
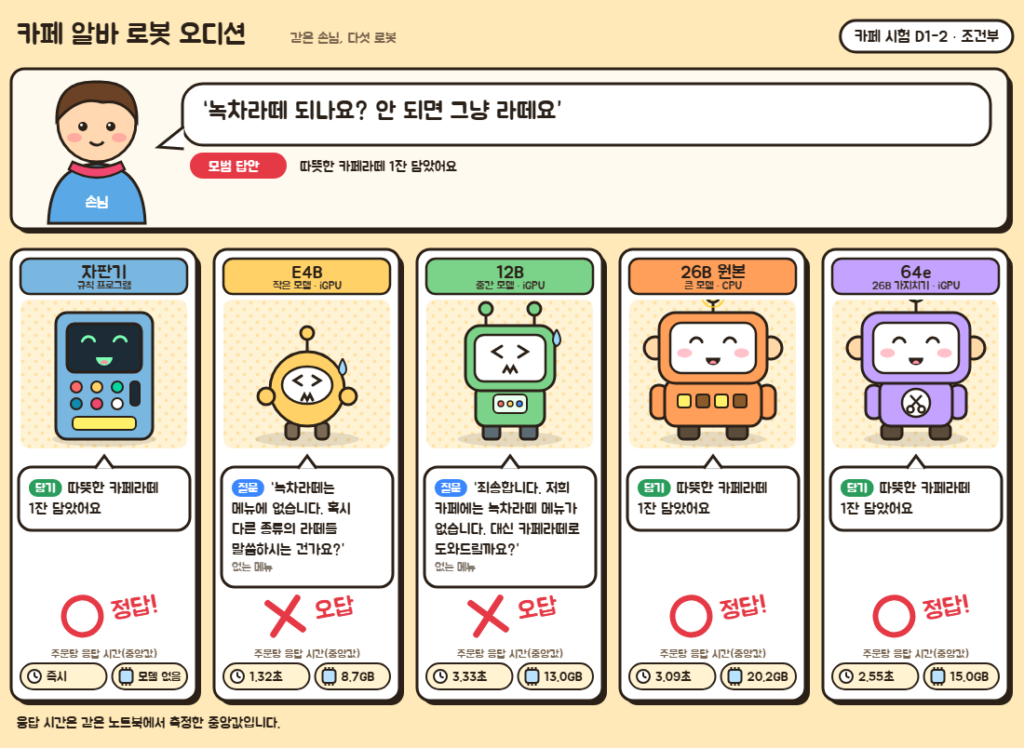
손님이 이미 대안까지 말해 줬는데, E4B와 12B는 “녹차라떼는 없는데 다른 라떼를 원하시나요?”라고 되물었습니다. 26B와 64e는 바로 카페라떼를 담았습니다. 사람으로 치면 ‘눈치’의 차이입니다.
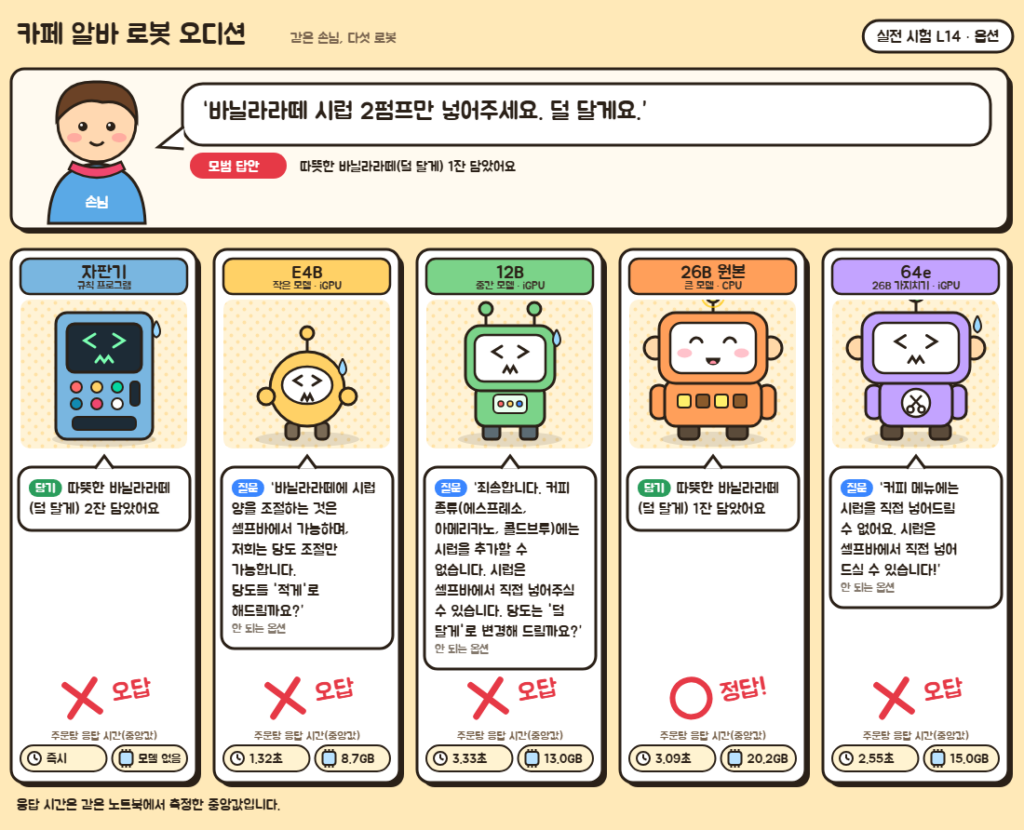
물론 잃은 것도 있습니다. 이 주문은 원본만 맞혔습니다. 가지치기한 모델들은 ‘커피에는 시럽 추가 불가’라는 규칙에 끌려 거절했고, 자판기는 ‘2펌프’의 2를 수량으로 읽어 두 잔을 담았습니다. 덜어낸 대가도 있다는 장면입니다(한 문제라 원인은 단정하지 않습니다).
6. 예상하지 못했던 발견들 (휴먼지능이 필수다)
6-1. 누가 만든 시험이냐가 결론을 바꾼다
전문가를 48명까지 줄였을 때, AI가 만든 카페 시험은 여전히 93.3%였습니다. 이것만 봤다면 “48명까지 줄여도 멀쩡하다”고 결론 냈을 겁니다.
하지만 사람이 쓴 실전 시험에서는 75%에서 50%로 무너졌습니다. 자판기(55%)보다도 낮습니다. 무너지는 순서도 뚜렷했습니다. 일반 지식 → 사람이 쓴 실전 문장 → 정형화된 카페 문장 순서입니다.
가지치기에 쓴 보정 문장과 비슷한 시험만 보면 가지치기는 늘 안전해 보입니다. 모델을 줄여서 쓰려는 팀이라면, 사람이 따로 쓴 평가 데이터가 꼭 필요합니다.
| 전공자 노트 ⑤ 내부 신호로는 예고되지 않았다 보정 문장에서 원본과 가지치기 모델의 다음 토큰 1순위 일치율은 98e 92.7%, 64e 80.3%, 48e 76.8%로 완만하게만 떨어져, 48e의 실전 붕괴를 미리 알려 주지 못했습니다. 층마다 같은 수를 남긴 것도 원인 후보입니다. REAP 손실이 컸던 가운데 층(7~9, 15~16)도 똑같이 잘랐습니다. |
6-2. 규칙 코드는 예상한 범위 안에서만 강하다 (룰 기반 한계)
“그냥 규칙으로 코딩하면 더 확실하지 않나?”라는 반론에 답하려고 넣은 자판기는, 카페 시험에서 95%로 1등을 했습니다. 그런데 실전 시험에서는 55%로 떨어졌습니다. “아샷추”를 ‘아아’와 ‘샷’으로 쪼개 읽고, “따뜻한 아이스”에서 ‘아이스’만 보고 담아 버렸습니다. 정해진 입력에는 규칙이 가장 빠르고 정확하지만, 손님 말은 정해져 있지 않습니다.
6-3. 속도를 가장 크게 바꾼 건 모델이 아니라 프롬프트 순서였다
16GB 노트북용으로 가볍게 만든 설정에서 문제가 하나 드러났습니다. 손님이 메뉴를 하나 담으면 ‘현재 주문 내역’이 바뀌는데, 그때마다 응답이 73초나 걸렸습니다. 로봇 앞의 손님은 그렇게 기다려 주지 않습니다.
원인은 프롬프트 배치였습니다. 매번 바뀌는 주문 내역이 고정된 도구 설명보다 앞에 있어서, 주문이 바뀔 때마다 그 뒤의 긴 설명을 처음부터 다시 계산하고 있었습니다. 주문 내역을 손님 말 바로 앞으로 옮기기만 했더니(글자는 그대로) 73초가 4.7초가 됐습니다(64e, 주문 내역이 바뀐 주문의 중앙값). 점수는 그대로였습니다.
에이전트를 만드는 분께 드리는 한 줄 팁입니다. 프롬프트는 안 바뀌는 것 → 가끔 바뀌는 것 → 매번 바뀌는 것 순서로.
| 전공자 노트 ⑥ 16GB 노트북과 캐시 올라마(gemma4 렌더러)는 도구 설명(약 1,100토큰)을 시스템 프롬프트 뒤에 붙입니다. 슬라이딩 윈도우 어텐션 모델에서 체크포인트가 없는 지점부터 접두부가 갈라지면 프롬프트 전체가 재계산됩니다. 배포용 배치에서는 약 3,470토큰까지 공유되어 재계산이 0번이었습니다. 이미지 처리 부품과 보조 생성 모델을 뺀 텍스트 전용 설정에서 CPU 정상 상태 메모리는 48e 8.4GB, 64e 10.1GB로, 운영체제 4GB를 더하면 16GB 노트북에 48e는 여유 있게, 64e는 빠듯하게 들어갑니다(16GB 실기기 측정은 아닌 추정). 같은 하드웨어에서 원본·98e·64e·48e의 생성 속도는 초당 13.7~15.0토큰으로 같았습니다. 가지치기가 주는 속도 이득은 ‘내장 GPU에 올라간다’에서 나옵니다. |
7. 이 실험의 한계
- 실전 시험은 20문제뿐입니다. 한 문제가 5%p이고, 통계 검정은 모든 비교에서 유의하지 않았습니다.
- 카페 시험, 자판기, 보정 문장, 시스템 프롬프트는 같은 AI 코딩 도구가 만들었습니다. 사람이 쓴 것은 실전 20문제와 그 정답뿐입니다.
- 모든 시험은 한 번씩만 돌렸고, 노트북 한 대와 올라마 한 버전에서 쟀습니다.
- 16GB 노트북 판정은 32GB 노트북 측정값으로 어림한 것입니다.
- 층마다 같은 수의 전문가를 남겼고, 가지치기 후 추가 학습은 하지 않았습니다.
마치며 (결론) – 나 램 16기가인데 AI 모델 큰 거 쓸래!
다시 카페로 돌아가 보겠습니다. 대학원생은 확실히 일을 잘했습니다. 실전 시험 1등은 늘 26B 원본이었습니다. 하지만 그 대학원생에게서 카페 일에 쓰지 않는 지식을 절반 덜어내도, 손님 말을 알아듣는 눈치는 대부분 남았습니다. 상식 퀴즈 점수는 크게 떨어졌지만, 반샷을 알아듣고, 대안을 말한 손님에게 되묻지 않고, 메뉴에 없는 걸 정중히 거절하는 능력은 처음부터 작게 태어난 지원자보다 나았습니다. 그리고 그 대학원생은 이제 노트북 내장 GPU에 들어갑니다.(사양이 높지도 않은 내장 GPU인데도요!)
다만 너무 많이 덜어내면(48명), 눈치도 함께 사라졌습니다. 그리고 그 사실은 AI가 만든 시험이 아니라 사람이 쓴 스무 문장에서만 드러났습니다. (너무 깎으면, 눈치도 같이 깎인다.)
이번 실험은 노트북까지 왔습니다. 여기서 더 해 볼 수 있는 것들도 보입니다. 실제 카페의 주문 데이터로 시험을 수백 문항으로 늘리는 것, 48명이 왜 무너졌는지 층별로 뜯어보고 층마다 남길 인원을 다르게 주는 것, 짧은 추가 학습으로 잃은 눈치를 되찾는 것, 그리고 음성 인식과 함께 노트북보다 작은 로봇·휴대폰의 신경망 처리 장치(NPU, Neural Processing Unit) 위에 올려 보는 것까지요. 기회가 된다면 그 이야기도 이어서 해 보겠습니다.
그리고 이번에 덜어낸 대학원생 64e는 허깅페이스(Hugging Face)에 공개해 두었습니다. 올라마만 있으면 명령어 한 줄로 직접 면접을 볼 수 있어요(실행 방법은 글 맨 아래 참고 자료에 있습니다). 써 보시고 마음에 드셨다면 하트(좋아요) 하나 부탁드립니다!
모델 페이지 바로가기: https://huggingface.co/SONGSSONG123/gemma4-26b-cafe-64e-text-GGUF
알바 공고의 결론은 이렇습니다. 결국 대학원생을 뽑았습니다. 다만 카페 일에 필요 없는 지식은 덜어내고, 노트북 한 대면 충분하다는 대학원생으로요. 단, 뽑은 후에 꼭 진짜 손님 말로 다시 면접을 보시는 걸 추천드립니다.
“이 로봇, 일은 참 잘하는데… 눈치가 없네!”
※참고 자료
- 실험 코드와 결과: github.com/gustjrvkdnj1234-png/cafe-robot-brain
- 공개 모델(64e, 텍스트 전용): huggingface.co/SONGSSONG123/gemma4-26b-cafe-64e-text-GGUF (올라마: ollama run hf.co/SONGSSONG123/gemma4-26b-cafe-64e-text-GGUF:Q4_K_M) — 보조 생성 모델이 빠져 있어 본문의 속도보다 느릴 수 있습니다.
- REAP: Lasby et al., “REAP the Experts: Why Pruning Prevails for One-Shot MoE Compression”, arXiv:2510.13999
- Gemma 4: Google DeepMind, Apache 2.0