검색 증강 생성(RAG, Retrieval-Augmented Generation)을 붙이면 대규모 언어 모델(LLM, Large Language Model)의 환각(Hallucination)은 줄어든다. 그런데 검색기가 관련 문단을 제대로 가져와도 문단과 문단을 잇는 논리는 여전히 LLM 몫이고, 답변만 보면 문서에서 나온 내용인지 모델이 원래 알던 내용인지 가려지지 않는다.
이번에 읽은 논문은 이 부분을 온톨로지(Ontology)로 풀어 보려 한다. 2026년 10월 arXiv에 올라온 「OA-RAG: Ontology-based Agentic RAG for Faithful LLM Reasoning」[1]으로, 맨체스터 대학교와 SNOMED International 연구진이 썼다. 논문이 제안한 OA-RAG(Ontology-based Agentic RAG)는 지식원을 문서에서 온톨로지로 바꾸고, 논리 추론은 LLM 대신 온톨로지 reasoner(추론 엔진)에 맡긴다.
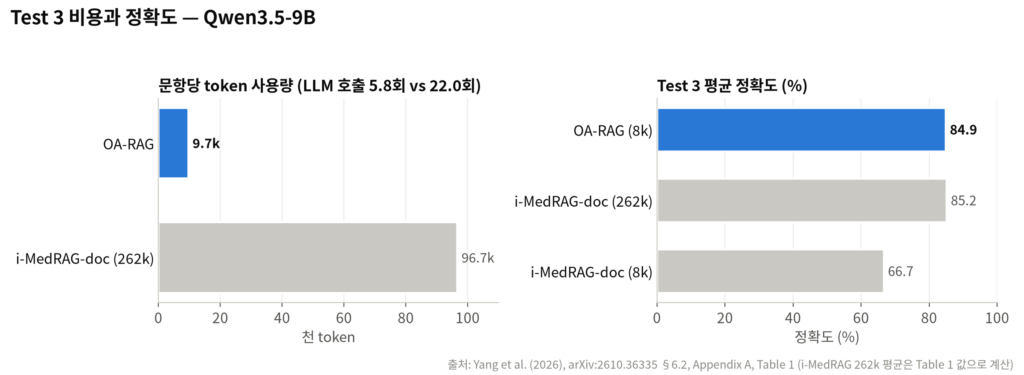
결과부터 적으면, 온톨로지에서 만든 문제(Test 1·2)에서는 가장 강한 baseline보다 평균 10~15%p(퍼센트포인트) 높았다. 의료 질의응답(QA, Question Answering) 문제(Test 3)에서는 Qwen3.5-9B 기준으로 262k token context를 준 의료 특화 RAG(i-MedRAG)와 정확도가 비슷했고, 문항당 token은 1/10 정도만 썼다. 같은 8k context에서 비교하면 Llama 쪽은 i-MedRAG가 조금 더 높았다.
표의 숫자는 좋다. 다만 실험 설계를 보면 걸리는 곳이 두 군데 있다. Test 1·2의 정답은 OA-RAG가 조회하는 바로 그 온톨로지의 추론 결과로 정해졌고, Test 3에서는 tool을 쓰는 ReAct loop와 answering 단계를 모두 빼도 정확도가 1%p도 안 떨어진다.
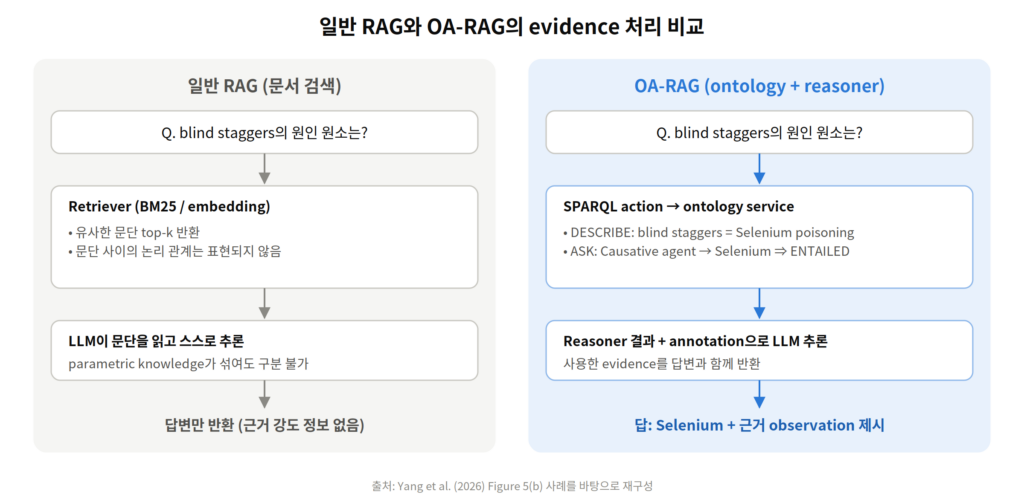
[그림 1] 일반 RAG와 OA-RAG의 evidence 처리 비교 (오른쪽 사례는 논문 Figure 5(b) 내용을 바탕으로 재구성)
1. 배경: 문서 검색만으로 부족한 지점
검색된 문단 하나에는 “A는 B의 일종이다”가, 다른 문단에는 “B는 C를 일으킨다”가 적혀 있다고 하자. “A는 C를 일으키는가”에 답하려면 두 문장을 이어 붙여야 하는데, 그 일은 LLM이 한다. 논문은 이 연결을 LLM이 맡는다는 점을 문제로 본다. 논리 관계를 담은 지식이 이미 바깥에 있는데 추론은 모델 안에서 일어나니, 답이 주어진 지식에 충실한지(faithfulness) 확인할 방법이 마땅치 않다.
바이오·의료 쪽은 사정이 조금 다르다. 이런 관계를 형식 언어로 정리해 둔 온톨로지가 이미 여럿 있다. 유전자 기능의 GO(Gene Ontology)[2], 식품 분류의 FoodOn[3], 임상 용어 체계인 SNOMED CT(Systematized Nomenclature of Medicine – Clinical Terms)[4] 같은 것들이다. OWL(Web Ontology Language)[5]로 작성되어 있거나 OWL로 변환해 쓸 수 있어서, reasoner를 돌리면 명시되지 않은 관계까지 기계적으로 뽑아낼 수 있다.
저자들은 reasoner의 논리 추론과 LLM의 자연어 추론을 온톨로지 위에서 함께 쓰면 도메인 질문에 더 충실하게 답하는지를 확인하려 했다.
2. 사전 지식: 온톨로지, axiom, reasoner
OWL 온톨로지는 개념(class), 관계(property), 그리고 둘 사이의 논리 규칙인 axiom(공리)으로 이루어진다. 논문 수식은 기술 논리(DL, Description Logic) 표기를 쓴다. A ⊑ B는 “A는 B의 하위 개념”, A ⊑ ∃r.B는 “모든 A는 관계 r로 어떤 B와 이어진다”로 읽는다. 논문의 질의와 문제는 대부분 이 두 형태로 만들어진다.
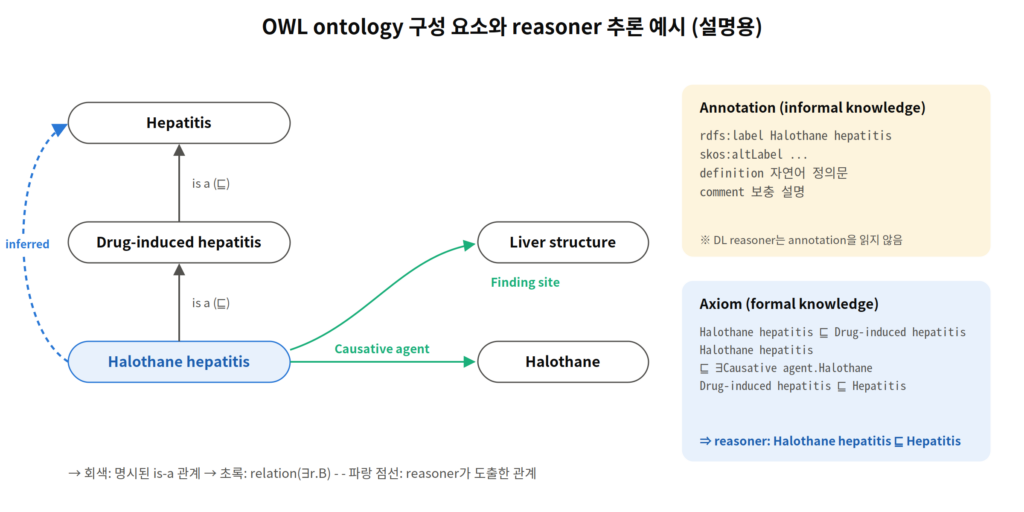
[그림 2] OWL 온톨로지 구성 요소와 reasoner 추론 예시 (SNOMED CT 개념명을 빌린 설명용 예시이며 실제 계층과 다를 수 있음)
[그림 2]에서 Halothane hepatitis는 Drug-induced hepatitis의 하위 개념이고, Drug-induced hepatitis는 다시 Hepatitis의 하위 개념이다. “Halothane hepatitis ⊑ Hepatitis”라는 axiom은 어디에도 없다. 그래도 reasoner는 두 axiom으로부터 이 관계를 도출한다.
온톨로지에는 axiom 말고도 이름, 동의어, 자연어 정의 같은 annotation이 붙는다. OWL 직접 의미론(Direct Semantics)에서 annotation은 추론에 쓰이지 않아서 reasoner는 이 정보를 아예 읽지 않는다. 정의문이나 comment에만 적혀 있고 axiom으로는 옮겨지지 않은 지식은 reasoner 입장에서 없는 지식이다. 그래서 OA-RAG는 axiom을 reasoner에, annotation의 자연어를 LLM에 나눠 맡긴다.
[표 1] 이 글에서 쓰는 주요 용어
| 용어 | 의미 |
| Axiom | 개념·관계 사이의 논리 규칙 (A ⊑ B, A ⊑ ∃r.B) |
| Annotation | label, 동의어(altLabel), definition, comment 등 자연어 정보. reasoner는 사용하지 않음 |
| Reasoner | axiom에서 명시되지 않은 관계를 도출하는 프로그램 (예: ELK, HermiT, Whelk) |
| SPARQL | SPARQL(SPARQL Protocol and RDF Query Language). RDF(Resource Description Framework) 그래프 질의 언어[6]. SELECT, ASK, DESCRIBE 등을 지원 |
| Entailment | 온톨로지에서 논리적으로 도출되는 관계. O ⊨ α로 표기 |
3. 세 가지 reasoning pattern
논문은 온톨로지와 LLM을 같이 쓰는 질의응답을 세 유형으로 나누는데, 평가 데이터(5.1절)와 grounding level(4.3절)도 이 세 유형에 맞춰 설계됐다.
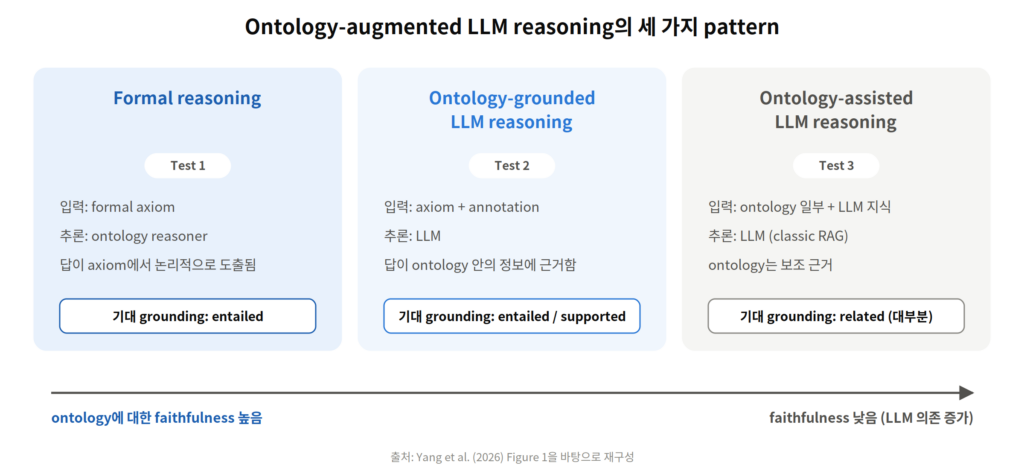
[그림 3] Ontology-augmented LLM reasoning의 세 가지 pattern (논문 Figure 1 내용을 바탕으로 재구성)
- Formal reasoning: axiom만으로 답이 나오므로 reasoner 하나로 풀린다.
- Ontology-grounded LLM reasoning: 필요한 정보가 온톨로지 안에 있긴 한데, 일부가 annotation에만 들어 있다. LLM이 axiom과 annotation을 같이 읽어야 풀린다.
- Ontology-assisted LLM reasoning: 온톨로지는 보조 근거로만 쓰이고 LLM 자체 지식이 더 많이 들어간다. 일반적인 문서 RAG가 여기에 가깝다.
어느 유형인지는 질문이 들어와 봐야 알 수 있어서, OA-RAG는 이 판단을 agent에게 맡긴다.
4. OA-RAG 구조
4.1 전체 흐름
OA-RAG는 ReAct(Reasoning and Acting) 방식 agent에 온톨로지 서비스를 tool로 붙인 구조다. 단계는 셋이다.
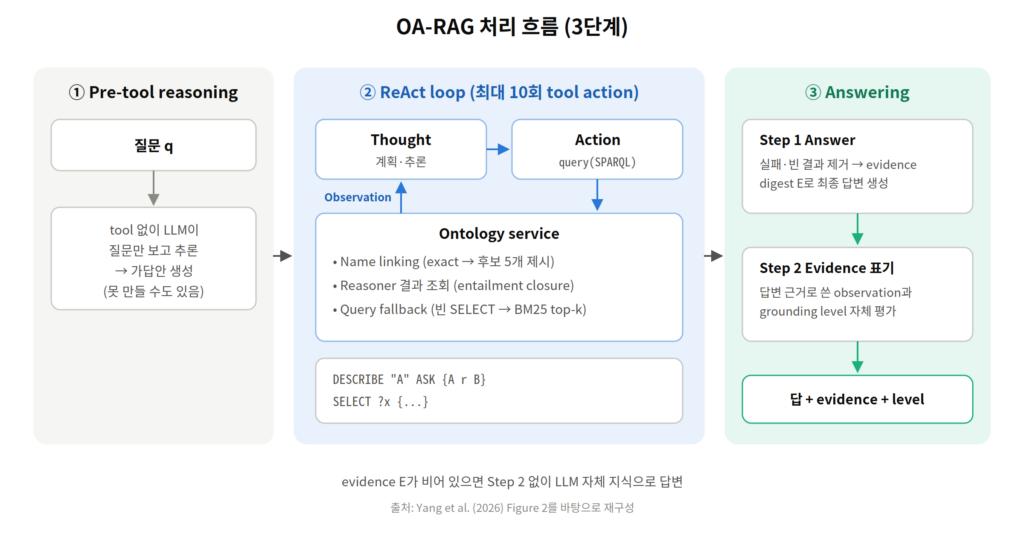
[그림 4] OA-RAG 처리 흐름 (논문 Figure 2를 바탕으로 재구성)
① Pre-tool reasoning. tool을 주기 전에 LLM이 질문만 보고 먼저 풀어 본다. 아는 문제면 여기서 가답안이 나온다. 이후 온톨로지는 빠진 정보를 채우거나 이 가답안을 검증·수정하는 데 쓰인다.
② ReAct loop. Thought → Action → Observation을 반복하는 익숙한 구조다. Action은 SPARQL 질의이고, 문항당 최대 10번까지 부를 수 있다. 질의 형태는 세 가지다.
[표 2] OA-RAG의 SPARQL action 종류
| Action | 형식 | 반환 내용 |
| DESCRIBE | DESCRIBE “A” | 개념 A의 concept card (이름, 정의, 상위·하위 개념, 관계, annotation) |
| ASK | ASK {“A” “r” “B”} | A ⊑ ∃r.B가 reasoner로 도출되면 Entailed, 아니면 Not Entailed |
| SELECT | SELECT ?x {?x “r” “B”} 등 | 조건을 만족하는 개념 또는 관계 목록 |
ASK가 Not Entailed를 돌려줬다고 그 관계가 거짓인 건 아니다. 온톨로지는 open-world assumption을 따르기 때문에 적혀 있지 않은 것과 틀린 것은 다르다. 저자들은 이 차이를 프롬프트에 직접 적어서 LLM이 Not Entailed를 부정으로 받아들이지 않게 했다.
③ Answering. loop가 끝나면 오류가 났거나 결과가 빈 observation을 버리고, 남은 것으로 evidence digest를 만든다. 질문과 evidence digest를 넣고 최종 답을 다시 생성하는데, ReAct loop가 후보 답을 이미 냈다면 그 답도 초안으로 함께 넣는다. 그다음 한 번 더 호출해서 어떤 evidence를 근거로 썼는지, grounding level은 무엇인지 출력하게 한다. 남은 evidence가 하나도 없으면 LLM이 자기 지식으로 답한다.
4.2 Ontology service
LLM이 짠 SPARQL이 한 번에 맞으리라는 보장은 없다. 개념 이름이 온톨로지 표기와 다르기도 하고 결과가 텅 비기도 한다. 저자들은 이런 실패를 온톨로지 서비스가 처리하게 했다.
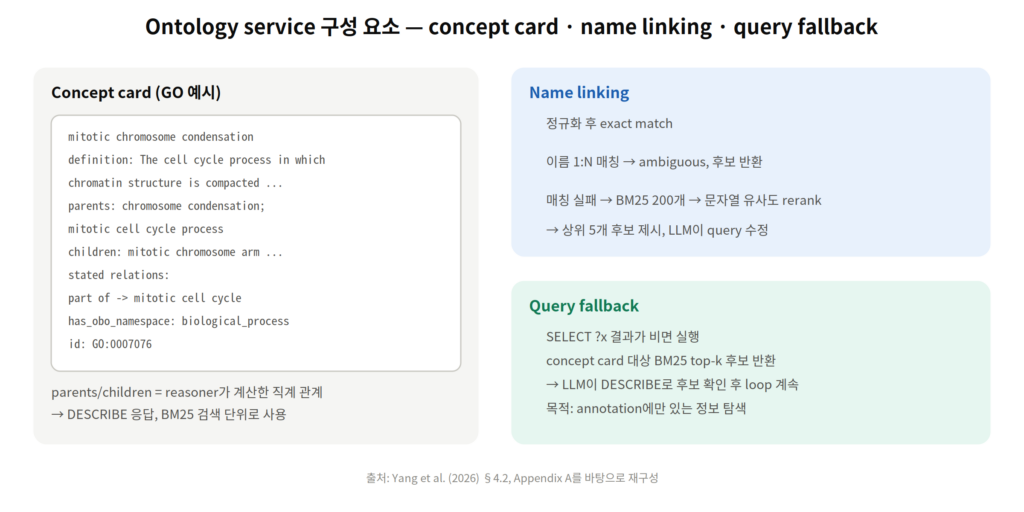
[그림 5] Ontology service 구성 요소 (논문 §4.2, Appendix A를 바탕으로 재구성)
Concept card는 개념 하나를 key: value 텍스트로 정리한 카드다. 상위·하위 개념 칸은 reasoner가 계산한 직계 관계로 채운다. DESCRIBE를 부르면 이 카드가 돌아오고, BM25(Best Matching 25) 검색도 카드 단위로 한다.
Name linking은 질의에 들어간 이름을 정규화해서 온톨로지 개념과 정확히 맞춰 본다. 안 맞으면 BM25로 후보 200개를 뽑고 문자열 유사도로 다시 줄 세워 상위 5개를 LLM에게 보여 준다. LLM은 이 목록을 보고 질의를 고쳐 쓴다.
Query fallback은 SELECT ?x 결과가 비었을 때 concept card를 BM25로 검색해 후보를 대신 돌려준다. annotation에만 있는 정보는 reasoner가 못 찾으니 텍스트 검색으로 메운다.
reasoner는 질의 때마다 돌지 않는다. OWL 2 EL 프로파일(OWL 2의 경량 하위 언어)용 reasoner인 Whelk[7]로 entailment closure를 미리 계산해 Oxigraph[8]에 넣어 두고, ASK와 SELECT는 이 저장소를 조회한다.
4.3 Grounding level
OA-RAG는 답과 함께 grounding level을 출력한다. evidence를 다 같은 무게로 보지 않고, 답과 evidence가 어떤 관계인지를 네 단계로 매긴다.
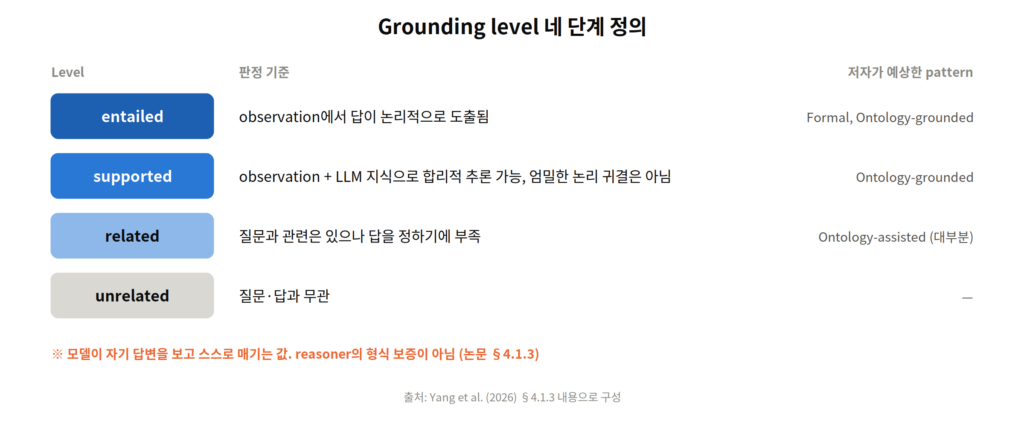
[그림 6] Grounding level 네 단계 정의 (논문 §4.1.3 내용으로 구성)
- entailed: observation에 적힌 사실에서 답이 논리적으로 도출된다.
- supported: observation에 LLM 지식을 보태 합리적으로 추론한 답이다. 엄밀한 논리적 귀결은 아니다.
- related: observation이 질문과 관련은 있지만 답을 정하기엔 부족하다.
- unrelated: observation이 질문, 답과 무관하다.
저자들은 [그림 3]의 formal reasoning에서는 entailed가, ontology-grounded에서는 entailed나 supported가, ontology-assisted에서는 주로 related가 나올 것으로 본다. 답을 받는 사람은 온톨로지에서 도출된 답과 온톨로지를 참고만 한 답을 나눠서 볼 수 있다.
단, 이 등급은 LLM이 스스로 붙인다. 논문도 grounding level이 정답을 형식적으로 보장하지 않는다고 적어 두었다. ASK의 Entailed는 reasoner가 판정한 값이고, grounding level의 entailed는 LLM이 붙인 값이다.
5. 실험5.1 평가데이터구성
테스트도 세 pattern에 맞춰 세 개다.
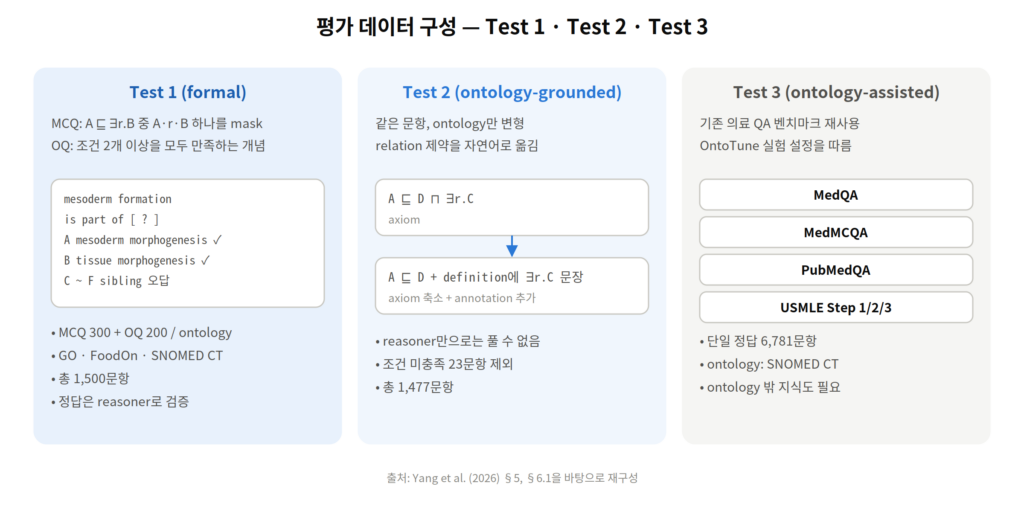
[그림 7] 평가 데이터 구성 (논문 §5, §6.1을 바탕으로 재구성)
- Test 1 (formal): GO, FoodOn, SNOMED CT에서 자동 생성한 문제다. 객관식(MCQ, Multiple-Choice Question)은 A ⊑ ∃r.B 형태의 axiom에서 A, r, B 중 하나를 가리고, 선택지 6개 중 맞는 것을 모두 고르게 한다. 주관식(OQ, Open Question)은 관계 조건을 2개 이상 주고 이를 모두 만족하는 개념을 찾게 한다. 온톨로지마다 객관식 300개, 주관식 200개로 총 1,500문항이고 정답은 reasoner로 검증했다.
- Test 2 (ontology-grounded): 문항은 Test 1과 같고 온톨로지를 손봤다. axiom의 관계 제약을 떼어 내 자연어 문장으로 바꾼 뒤 개념의 definition에 붙였다. reasoner만으로는 못 풀고 정의문을 읽어야 풀리게 했다. 조건에 맞지 않는 23문항을 빼서 1,477문항이다.
- Test 3 (ontology-assisted): MedQA, MedMCQA, PubMedQA, USMLE(United States Medical Licensing Examination) Step 1~3에서 정답이 하나인 6,781문항이다. 온톨로지는 SNOMED CT를 쓴다.
모델은 Llama-3-8B-Instruct와 Qwen3.5-9B다. 비교 대상으로는 사고 연쇄(CoT, Chain-of-Thought) 프롬프팅, 온톨로지 concept card를 검색하는 RAG(RAG-ont)와 ReAct(ReAct-ont), 의료 교과서와 StatPearls를 검색하는 RAG(RAG-doc)·MedRAG·i-MedRAG가 들어갔다. SNOMED CT 지식으로 fine-tuning한 OntoTune 계열도 있는데, Llama 기반만 있고 Test 3 수치는 논문[1]이 OntoTune 원 논문에서 옮겨 왔다.
context window는 Llama 최대치인 8,192 token에 모두 맞췄다. 다만 i-MedRAG는 짧은 context에서 성능이 크게 떨어져서, Qwen에서는 262k token으로 돌린 결과를 추가로 보고했다.
채점은 꽤 엄격하다. MCQ는 고른 선택지 집합이 정답 집합과 정확히 같아야 맞는다. OQ는 답이 비어 있지 않고 전부 맞아야 정답이다. 문항이 정답 개념을 “하나 이상” 찾으라고 하므로 일부만 찾아도 틀린 것이 없으면 정답이 되는 구조로 보인다.
5.2 주요결과
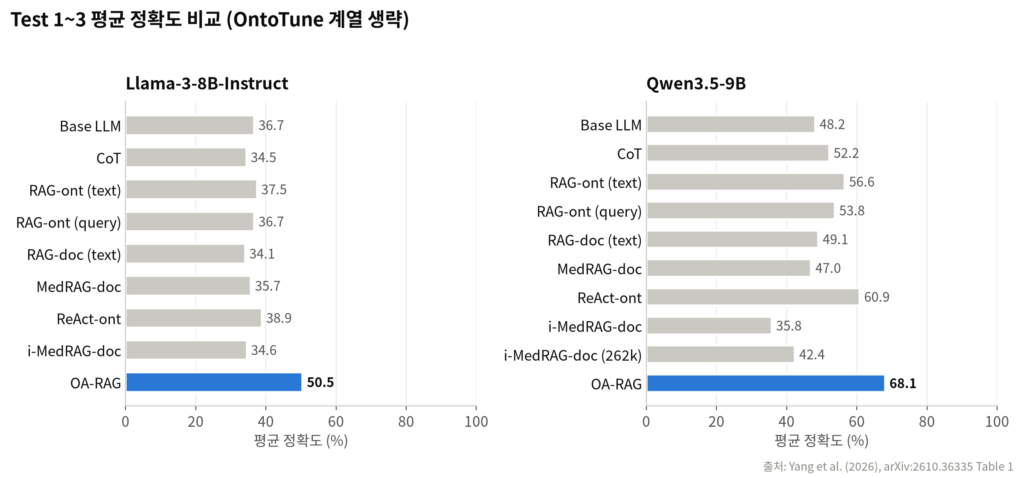
[그림 8] Test 1~3 평균 정확도 비교 (논문 Table 1 수치로 작성, OntoTune 계열 생략)
세 테스트 평균은 두 모델 모두 OA-RAG가 가장 높다(Llama 50.5%, Qwen 68.1%). Test 1·2만 떼어 보면 가장 강한 baseline은 두 모델 모두 같은 온톨로지를 쓰는 ReAct-ont였는데, Llama 44.3% 대 28.9%, Qwen 59.7% 대 49.7%로 차이가 컸다.
일부 설정에서는 OA-RAG가 졌다. Llama의 Test 2 객관식에서는 concept card를 텍스트로 검색하는 RAG-ont(53.4%)가 OA-RAG(52.2%)보다 조금 높았다. Qwen의 Test 2 주관식에서는 ReAct-ont(32.9%)가 OA-RAG(23.2%)를 10%p 가까이 앞섰다. 이유는 부록에 있었다. GO 온톨로지 Test 2 주관식에서 Qwen의 exact query는 정답 개념을 거의 못 찾았고, 200문항 중 62.5%는 아예 답을 내지 못했다. 적어도 GO에서는 정의문에만 있는 정보를 텍스트 검색 쪽이 더 잘 찾았다.
MedRAG와 i-MedRAG는 Test 1·2에서 대부분 base 모델보다도 낮았다. Qwen의 MedRAG 객관식 하나만 예외다. 저자들은 의료 RAG가 명시적 논리 추론이 필요한 문제에 약하다고 해석했다. 필자는 지식원 차이도 크다고 본다. 의료 교과서에서 GO나 FoodOn의 개념 관계를 찾기는 어렵다.
5.3 비용
Test 3은 정확도보다 비용 차이가 크다.
[그림 9] Test 3 비용과 정확도 비교, Qwen3.5-9B (논문 §6.2, Appendix A, Table 1 수치로 작성)
Qwen에서 i-MedRAG에 262k token context를 주면 Test 3 평균은 85.2%로 OA-RAG(84.9%)와 거의 같다. 85.2%는 논문에 바로 나오는 값이 아니어서 Table 1의 데이터셋별 수치로 직접 평균을 냈다. 차이는 사용량에서 벌어진다. 문항당 OA-RAG는 9.7k token에 LLM 호출 5.8회, i-MedRAG는 96.7k token에 22.0회다. i-MedRAG가 읽는 검색 문서만 63.6k token인데 OA-RAG가 읽는 온톨로지 observation은 1.0k token이다. i-MedRAG를 8k context로 묶으면 66.7%까지 내려간다.
저자들은 이 결과를 들어 온톨로지가 효율적인 지식원이라고 말한다. 그런데 6장에서 다시 보겠지만 Test 3 정확도는 대부분 모델 자체 지식에서 나왔다. 이 숫자로 말할 수 있는 건 긴 문서를 읽지 않고도 비슷한 정확도가 나왔다는 점이다. 온톨로지가 정확도를 끌어올렸다는 근거로 쓰기는 어렵다.
Llama 쪽은 또 다르다. 8k context의 i-MedRAG가 Test 3 평균 64.7%로 OA-RAG(62.8%)보다 높았다. 이 값도 Table 1로 직접 계산했다.
5.4 Grounding level과 정확도
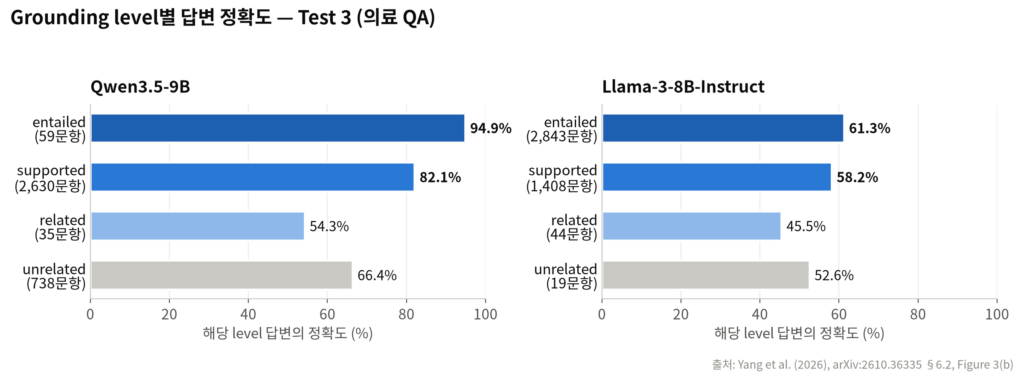
grounding level을 신뢰도 신호로 쓸 수 있는지는 Test 3 결과로 볼 수 있다.
[그림 10] Grounding level별 답변 정확도, Test 3 (논문 §6.2, Figure 3(b) 수치로 작성)
Qwen의 Test 3에서는 entailed가 붙은 답의 94.9%, supported가 붙은 답의 82.1%가 정답이었다. 나머지는 72.1%였다. 논문은 이를 근거로 등급이 높을수록 정확하다고 설명한다.
Llama를 보면 얘기가 달라진다. Test 3에서 2,843문항(약 42%)에 entailed를 붙였는데 정확도는 61.3%로, supported(58.2%)와 별 차이가 없고 Llama의 Test 3 전체 평균 62.8%와도 비슷하다. 설계대로라면 Test 3은 대부분 related가 나와야 하는 문제인데, Llama는 근거가 약한 답에도 entailed를 쉽게 붙였다. Qwen 쪽도 마냥 좋게 볼 수는 없다. entailed가 59문항뿐이라 94.9%라는 숫자를 얼마나 믿을지 애매하다.
5.5 검색 단계의 병목
Test 1·2는 정답 근거를 온톨로지에서 정확히 추적할 수 있다. 그래서 필요한 evidence를 찾았는지와 찾은 걸 실제로 인용했는지를 나눠서 잴 수 있다. 정답 근거를 전부 찾은 비율은 객관식 61.7%, 주관식 23.6%에 그쳤다. 한번 찾은 근거는 잘 썼다. 객관식에서 95.1~98.4%, 주관식에서도 77.8% 이상이 답변 근거로 인용됐다. 추론보다 검색이 병목이라는 게 저자들 결론이고, 선택지라는 힌트가 없는 주관식에서 특히 그랬다.
5.6 Ablation
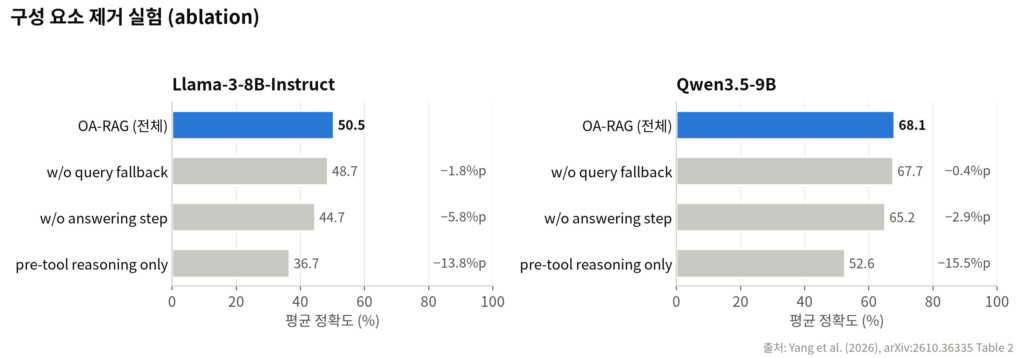
[그림 11] 구성 요소 제거 실험 (논문 Table 2 수치로 작성)
ReAct loop와 answering 단계를 모두 빼고 pre-tool reasoning만 남기면 평균이 Llama에서 13.8%p, Qwen에서 15.5%p 떨어진다. 빠진 점수는 거의 Test 1·2에서 나왔다. answering 단계만 빼도 2.9~5.8%p가 빠진다.
query fallback은 평균으로 보면 0.4~1.8%p라 존재감이 약하다. 원래 노린 Test 2 주관식만 보면 사정이 다르다. fallback을 넣었을 때 Llama가 9.3%에서 18.0%로, Qwen이 17.8%에서 23.2%로 올랐다. 반면 객관식은 Test 1·2 모두, 두 모델 모두에서 fallback이 없을 때 점수가 조금 더 높았다(최대 2.1%p).
5.7 사례
논문 Figure 5(b)에 실린 사례다.
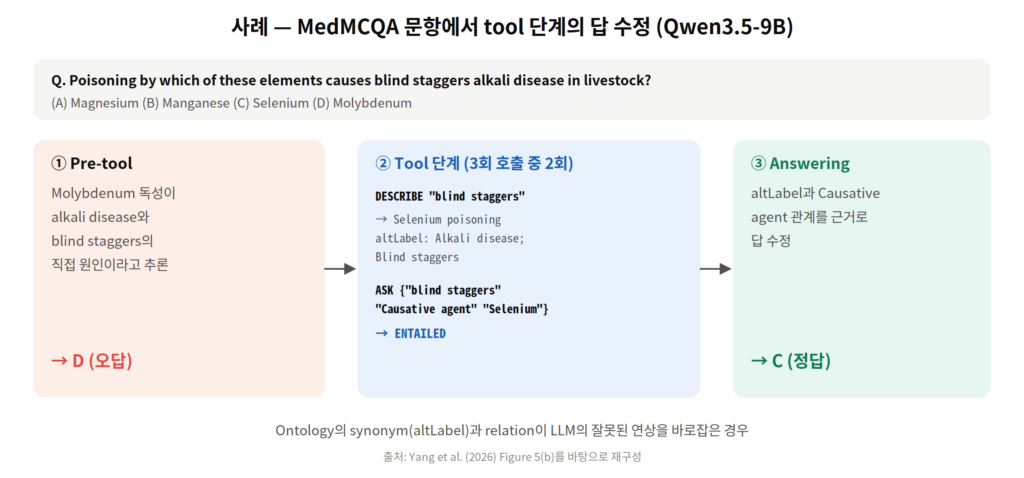
[그림 12] MedMCQA 문항에서 tool 단계의 답 수정 사례, Qwen3.5-9B (논문 Figure 5(b)를 바탕으로 재구성)
가축의 blind staggers 원인을 묻는 MedMCQA 문항이다. 모델은 처음에 Molybdenum을 골랐는데, tool 단계에서 DESCRIBE로 blind staggers를 조회했더니 이 이름이 Selenium poisoning의 동의어(altLabel)로 올라 있었다. 이어서 ASK로 Selenium이 원인 물질(Causative agent)인지 물었고 Entailed가 돌아왔다. 모델은 답을 Selenium으로 바꿨다. 저자들 설명으로는 온톨로지에 질문과 바로 닿는 관계가 있을 때 tool 단계의 효과가 가장 크다.
6. 비판적 검토
평가 설계와 시스템 구조의 일치. Test 1·2의 정답은 reasoner가 도출한 entailment로 정해진다. 객관식에서는 가려진 개념과 taxonomy상 가까운 상위·하위 개념도 정답으로 친다. entailment closure를 그대로 조회하는 OA-RAG에는 처음부터 유리한 시험이다. 같은 온톨로지를 검색하는 baseline을 크게 앞선 건 사실이지만 출발선은 같지 않았다. Test 2도 axiom의 관계 제약을 자연어 문장으로 기계적으로 바꿔(verbalise) 정의문에 붙인 합성 데이터다. 사람이 직접 쓴 정의문은 표현이 훨씬 제각각이라, 실제 온톨로지에서도 같은 성능이 나올지는 아직 모른다.
Test 3에서 온톨로지의 작은 기여. ReAct loop와 answering 단계를 모두 뺀 pre-tool reasoning만으로 Test 3 평균이 Qwen 84.7%, Llama 61.9%가 나온다. 전체 OA-RAG(84.9%, 62.8%)와는 0.2~0.9%p 차이다. 같은 두 단계가 Test 1·2에서는 8~53%p를 올렸다.
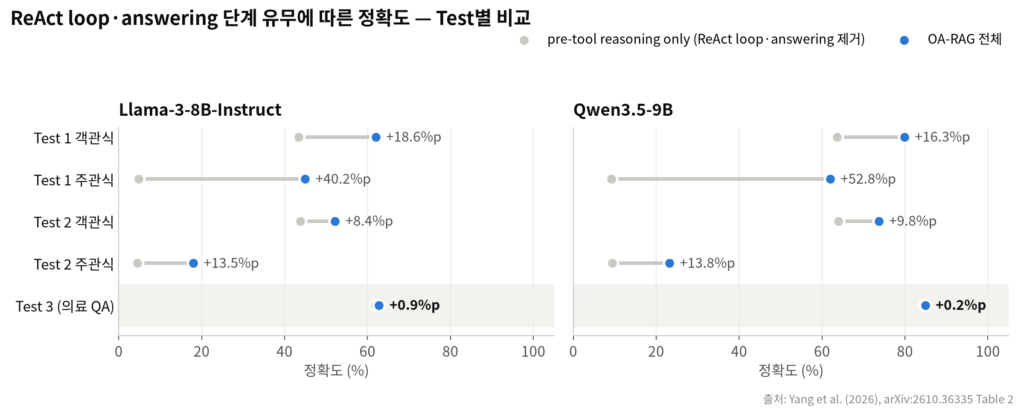
[그림 13] Test별 pre-tool reasoning only와 OA-RAG 전체의 정확도 비교 (논문 Table 2 수치로 작성)
[그림 12] 같은 수정 사례가 있긴 해도, 실제 의료 QA에서 tool 단계가 평균 정확도에 더한 몫은 1%p가 안 된다.
스스로 매기는 grounding level. 5.4절의 Llama 결과에서 entailed는 정답과 오답을 거의 가르지 못했다. 이 값을 서비스에서 신뢰도 표시로 쓰려면 검증 장치를 따로 두어야 한다. 예를 들어 답변이 인용한 evidence 가운데 reasoner가 실제로 Entailed를 돌려준 것이 있는지 규칙으로 확인하고, 없으면 등급을 낮추는 식이다.
실험 범위. 모델은 8B·9B, context는 8k였다. 더 큰 모델이나 긴 context에서도 차이가 유지될지는 알 수 없다. i-MedRAG만 해도 context를 262k로 늘리자 Test 3에서 OA-RAG를 따라잡았다. 반복 실행 횟수나 분산도 보고되지 않아서 84.9% 대 85.2% 정도의 차이로는 어느 쪽이 낫다고 말할 수 없다.
온톨로지 확보 비용. OA-RAG는 잘 만든 OWL 온톨로지가 있다는 전제에서 출발한다. 바이오·의료처럼 공용 온톨로지가 갖춰진 분야가 아니면 온톨로지를 만들고 관리하는 비용이 RAG 개선 효과보다 클 수 있다. closure를 미리 계산해 두는 구조라 온톨로지가 자주 바뀌는 환경이라면 재계산 주기도 따져 봐야 한다.
덧붙여 2026년 11월 11일 기준으로 이 논문은 arXiv에만 올라와 있다. Semantic Scholar에서도 학회·저널 게재 정보는 나오지 않았고, 본문에서 코드 링크도 찾지 못했다. 심사를 거치며 실험 설정이나 수치가 바뀔 수도 있다.
7. 실무적용 관점
사내에 OWL 온톨로지를 갖춘 팀은 많지 않을 것이다. 그래도 구조화된 지식을 tool로 여는 방식은 그대로 옮겨 올 수 있다. 사내 코드 체계, 제품 분류, 조직도처럼 관계가 분명한 데이터라면 텍스트로 잘라 임베딩하는 대신 조회·검증용 API(Application Programming Interface)로 열어 두는 방법이 있다. 조회 결과를 짧게 돌려주면 context 사용량도 줄어든다(5.3절).
작게 시도해 볼 만한 것도 몇 가지 있다.
- 조회 결과가 비었을 때 “없음”을 “틀림”으로 읽지 않도록 tool 설명과 프롬프트에 적어 둔다.
- 정확히 맞는 이름이 없으면 오류만 돌려주지 말고 후보 목록을 같이 준다. 그러면 agent가 질의를 알아서 고친다.
- 실패한 tool 결과를 걸러 낸 뒤 답을 다시 생성하는 단계를 넣는다. ablation에서 두 모델 모두 효과가 있었다.
답변에 쓴 근거와 그 근거가 규칙으로 검증된 것인지를 같이 보여 주면 사용자가 답을 검토하기 편하다. 다만 등급을 LLM의 자기 평가에만 맡기면 5.4절의 Llama처럼 엉뚱한 등급이 붙는다. 등급은 tool 결과를 보고 규칙으로 정하는 쪽을 먼저 검토하겠다.
8. 정리
OA-RAG는 axiom은 reasoner에게, annotation은 LLM에게 맡기고 둘 사이를 SPARQL tool을 쓰는 ReAct agent로 이었다. Qwen 기준으로는 의료 QA에서 262k context의 문서 기반 agent와 비슷한 정확도를 1/10 정도의 token으로 냈다. 다만 Llama에서는 8k context의 i-MedRAG가 더 높았고, 온톨로지가 정확도까지 올렸는지는 Test 3만으로 판단하기 이르다.
사내 RAG에 먼저 시험해 볼 부분은 구조화된 지식을 tool로 조회하게 하고 답마다 근거를 돌려주는 방식이다. OWL 온톨로지가 없는 환경에서 같은 효과가 나는지는 논문이 다루지 않았으니, 작은 데이터로 직접 확인해 봐야 한다.
참고 자료
[1] Yang et al., “OA-RAG: Ontology-based Agentic RAG for Faithful LLM Reasoning”, arXiv 2026-10. https://arxiv.org/abs/2610.36335 — 이 글에서 리뷰한 논문
[2] Gene Ontology Consortium, Gene Ontology Resource. https://geneontology.org/ — 유전자 기능 온톨로지(GO)
[3] FoodOn Consortium, FoodOn. https://foodon.org/ — 식품 분류 온톨로지
[4] SNOMED International, SNOMED CT. https://www.snomed.org/ — 임상 용어 체계
[5] W3C, “OWL 2 Web Ontology Language Document Overview (Second Edition)”, W3C Recommendation, 2012-12-11. https://www.w3.org/TR/owl2-overview/ — OWL 2 표준 개요
[6] W3C, “SPARQL 1.1 Query Language”, W3C Recommendation, 2013-03-21. https://www.w3.org/TR/sparql11-query/ — SPARQL 질의 언어 표준
[7] INCATools, Whelk. https://github.com/INCATools/whelk — OA-RAG가 entailment closure 계산에 쓴 OWL reasoner
[8] Oxigraph. https://github.com/oxigraph/oxigraph — OA-RAG가 closure 저장·조회에 쓴 SPARQL 그래프 데이터베이스
※ 비교 기법(ReAct, MedRAG, i-MedRAG, OntoTune)과 평가 데이터셋(MedQA, MedMCQA, PubMedQA)의 원 논문은 논문 [1]의 참고문헌에 정리되어 있다.