들어가며
쇼핑몰 고객 문의를 처리하는 대규모 언어 모델(LLM, Large Language Model) 기반 에이전트를 만들었다고 해 봅시다. 처음 만든 기능이 환불 처리였기 때문에 프롬프트도 환불 중심으로 쓰여 있습니다. 주문을 조회하고, 환불 가능 여부를 확인하고, 환불을 접수하는 흐름입니다.
그런데 이 에이전트가 이상하게 움직이기 시작합니다.
- “주문한 거 언제 와요?” → 환불 정책을 안내한다.
- “이 신발 사이즈가 정사이즈인가요?” → 반품·환불 절차를 덧붙인다.
- “비밀번호를 바꾸고 싶어요” → 최근 주문을 조회하고 환불 가능 여부를 확인한다.
모든 문의가 환불 흐름으로 빨려 들어갑니다. 가장 흔한 첫 대응은 프롬프트에 한 줄을 더하는 것입니다. “환불 요청이 아니면 환불 안내를 하지 마세요.” 당장은 나아지지만 상품 문의, 교환, 쿠폰처럼 유형이 늘 때마다 예외 문장이 쌓이고, 문장끼리 부딪히기 시작합니다.
이 글은 이 문제를 프롬프트 수정이 아니라 구조의 문제로 보고, 여섯 가지 해결 구조를 비교합니다. 마지막에는 어떤 상황에서 무엇을 고를지 정리합니다.
1. 문제의 뿌리와 비교의 기준
위 에이전트의 문제는 두 가지로 요약됩니다.
- 문의 유형을 따로 판단하는 단계가 없습니다. 배송·환불·상품·계정 문의가 모두 같은 프롬프트, 같은 도구 목록으로 처리됩니다.
- 기본값이 환불입니다. 프롬프트의 대부분이 환불 절차를 설명하고 있으니, 모델은 애매하면 환불 쪽으로 기웁니다.
즉 “이 요청이 어떤 종류인가”를 시스템이 따로 판단하고 다루는 단계가 없습니다. 그래서 해결책은 결국 유형에 따른 편향을 어디서, 무엇으로 막을 것인가를 정하는 일이 됩니다. 이 글은 이것을 제어의 위치라고 부르고, 문의가 들어와서 답이 나가기까지의 흐름 순서대로 여섯 구조를 놓습니다.
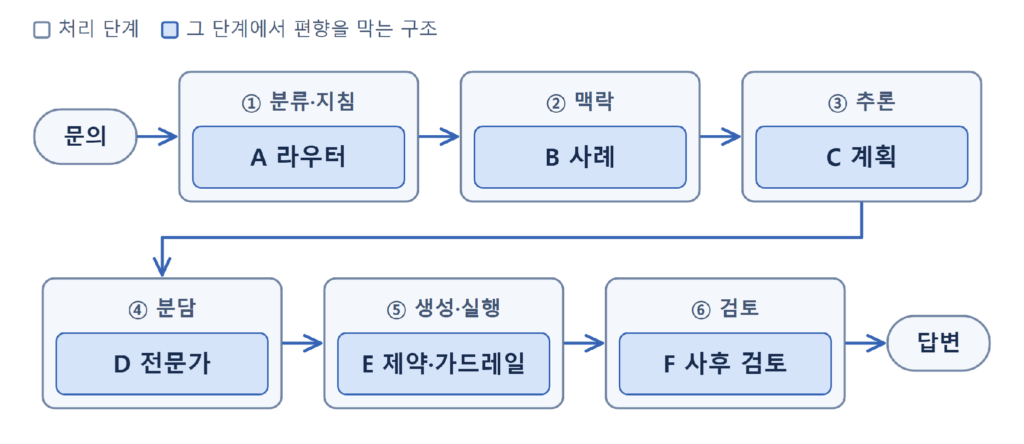
그림 1. 각 구조가 주로 개입하는 처리 단계 — 모든 구조를 차례로 거친다는 뜻은 아님 (필자 구성, 생성형 AI로 제작)
| 구조 | 제어의 위치 | 한 줄 요약 |
|---|---|---|
| A. 라우터 | 앞단의 분류 + 유형별 지침 | 유형을 먼저 가리고, 유형에 맞는 지침으로 바꿔 끼운다 |
| B. 사례 기반 | 데이터(검증된 처리 사례) | 규칙 대신 비슷한 사례를 찾아 따라 하게 한다 |
| C. 계획 후 실행 | LLM 자신의 추론 | LLM이 먼저 “무슨 요청인가”를 명시적으로 판단한 뒤 실행한다 |
| D. 전문가 에이전트 | 유형별 에이전트 | 유형마다 전담 에이전트를 둔다(관리자형 / 넘기기형) |
| E. 선언적 제약·가드레일 | 구조 규칙과 정책 | 허용된 처리 순서와 행동만 가능하게 강제한다 |
| F. 사후 검토 | 생성 뒤의 검토자 | 만든 결과를 별도의 검토 호출로 확인해 고치게 한다 |
여섯 구조는 일부 겹치고, 실제로는 섞어 씁니다(10절). 그래도 “어디서 막는가”는 저마다 다릅니다.
2. A. 라우터 — 먼저 가르고, 지침을 바꿔 끼운다
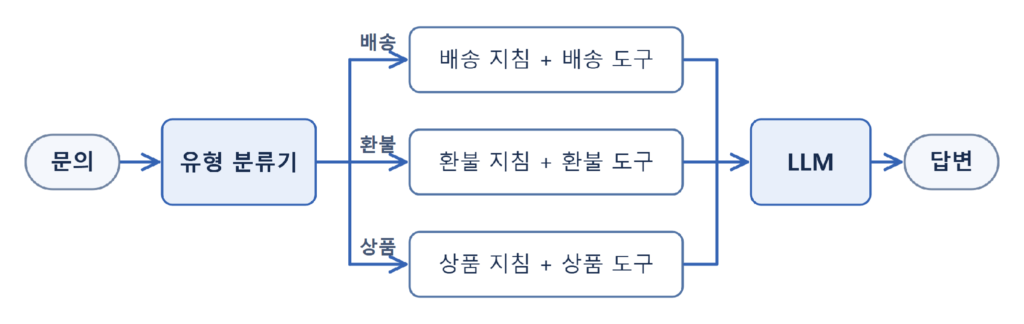
그림 2. 라우터: 유형을 먼저 분류하고, 유형별 지침과 도구를 붙여 LLM을 부른다 (필자 구성, 생성형 AI로 제작)
입력을 의도 유형으로 먼저 분류(의도 분류, intent classification)하고, 유형별 지침과 도구만 붙여 LLM을 부릅니다.
Anthropic이 “Building effective agents”에서 소개한 라우팅(routing) 패턴이 이것입니다[1]. 분류기는 키워드 규칙, 임베딩 유사도로 고르는 시맨틱 라우팅(semantic routing, 예: semantic-router[5])도 가능하고, 작은 LLM으로 만들거나, 별도 분류기 없이 LLM이 도구 호출로 경로를 고르게 할 수도 있습니다.
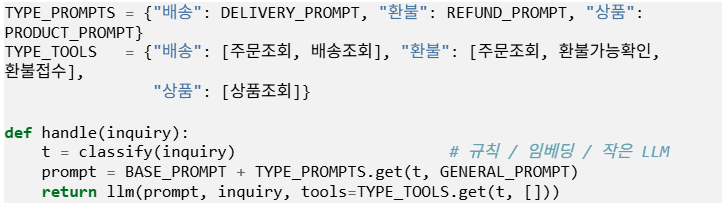
- 장점: 검증된 패턴이고, 분류를 규칙으로 하면 결과가 매번 같습니다. 유형 하나를 더할 때 지침 하나와 분류 규칙 하나만 늘어납니다. 기존 프롬프트를 유형별로 쪼개는 것에서 시작할 수 있어 점진적으로 도입하기 좋습니다.
- 단점: 전체 품질이 분류기 정확도에 묶입니다. 유형 경계가 모호한 문의(“배송이 너무 늦어서 환불받고 싶어요”)는 잘못 보내기 쉽습니다. 유형이 늘면 지침 묶음을 관리하는 부담도 늘어납니다.
- 잘 맞는 상황: 유형이 비교적 뚜렷하고 수가 관리할 만할 때. 이런 조건이라면 가장 손쉽게 시작할 수 있는 구조입니다.
변형 1. 프롬프트 템플릿 — 지침 대신 변수를 바꿔 끼운다
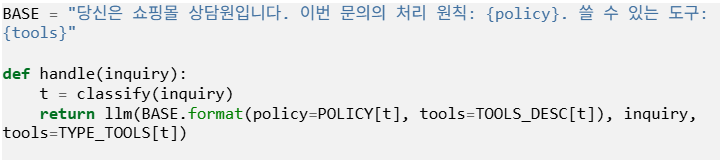
OpenAI의 에이전트 가이드는 지침을 유형별로 여러 벌 두는 대신, 기본 프롬프트 하나에 정책 변수를 끼우는 템플릿을 권합니다[3]. 유형마다 다른 부분만 변수로 바꾸므로, 유형별 지침이 대부분 비슷할 때 관리가 훨씬 가볍습니다.
변형 2. 스킬 — 지침을 묶어 두고, 모델이 골라 읽는다
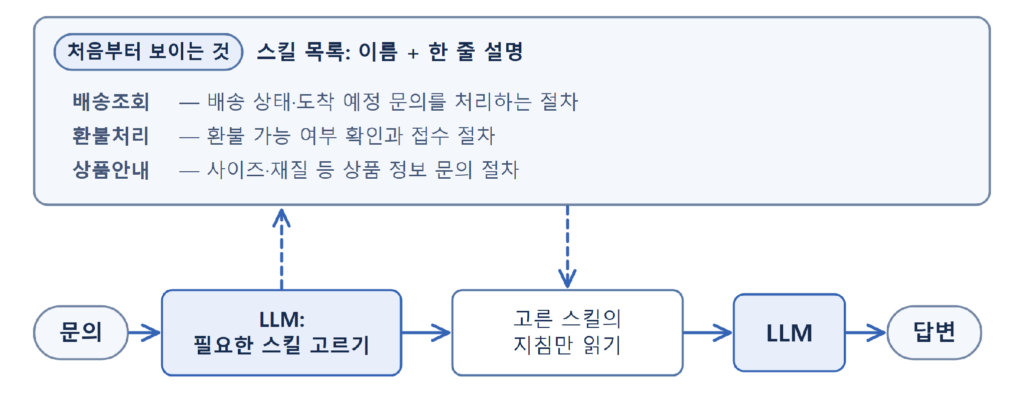
그림 3. 스킬: 이름과 한 줄 설명만 보고 고른 뒤, 고른 스킬의 지침만 읽는다 (필자 구성, 생성형 AI로 제작)
Anthropic이 2025년 10월 발표한 Agent Skills 방식입니다[2]. 유형별 절차를 “스킬”이라는 문서 묶음으로 만들어 두고, 모델에게는 처음에 스킬의 이름과 한 줄 설명만 보여 줍니다. 모델이 관련 있다고 판단하면 그 스킬의 핵심 지침을 읽고, 딸린 자료는 필요할 때만 더 읽습니다. Anthropic은 이것을 “점진적 공개(progressive disclosure)”라고 부릅니다.
2025년 12월에는 이 형식이 여러 플랫폼에서 함께 쓸 수 있는 공개 표준으로 공개되어[14], 특정 회사의 기능이라기보다 지침을 묶어 두는 일반적인 방법이 되었습니다.
유형별 지침을 바꿔 끼운다는 점에서 라우터의 변형입니다. 차이는 지침을 붙이는 시점과 방식입니다. 기본형은 앞단에서 한 번 정해 붙이고, 스킬은 모델이 작업하면서 필요한 만큼 단계적으로 읽어 들입니다.
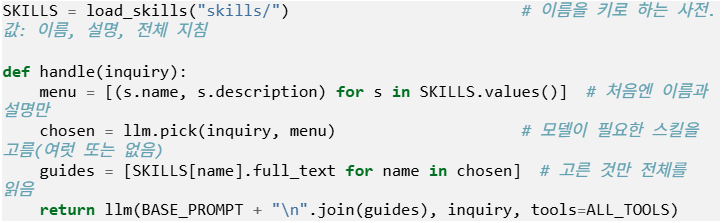
- 기본형보다 나은 점: 지침이 많아도 평소에는 이름과 설명만 맥락에 올라가 가볍습니다. 유형 하나를 더하는 일이 스킬 문서 하나를 쓰는 일이라 개발자가 아닌 사람도 기여할 수 있습니다. “배송 지연 + 환불”처럼 두 유형이 섞이면 스킬 둘을 함께 읽으면 되니, 기본형의 약점인 복합 요청에 강합니다.
- 기본형보다 못한 점: 고르는 것이 모델이라, 설명 문구가 모호하거나 모델이 약하면 필요한 스킬을 안 읽거나 엉뚱한 것을 읽습니다. 같은 문의에도 고르는 스킬이 달라질 수 있어 일관성이 떨어집니다. 스킬 수가 늘면 처음부터 보이는 이름·설명 목록도 그만큼 길어집니다.
- 잘 맞는 상황: 유형·절차가 많고 계속 늘어나며, 판단력이 충분한 모델을 쓸 때.
3. B. 사례 기반 — 규칙 대신 예시를 보여 준다
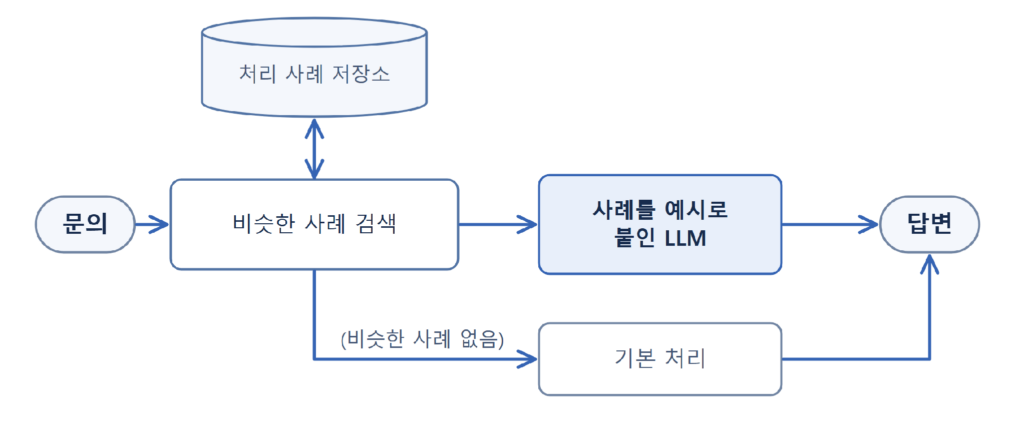
그림 4. 사례 기반: 비슷한 처리 사례를 찾아 예시로 붙이고, 없으면 기본 처리로 보낸다 (필자 구성, 생성형 AI로 제작)
프롬프트의 규칙을 줄이고, 상담사가 검증한 처리 사례(문의 → 처리 순서 → 답변)를 검색해 예시로 보여 줍니다. “배송 언제 와요?”에는 배송 조회로 끝난 사례가 붙으니, 환불 쪽으로 기울던 편향을 예시로 덮을 수 있습니다. 유형도 사례가 암묵적으로 정합니다. 검색 증강 생성(RAG, Retrieval-Augmented Generation)[6]을 응용한 방식이고, 비슷한 예시를 골라 붙이는 소수 예시(few-shot) 선택[7], 사례 기반 추론(CBR, Case-Based Reasoning)과 같은 계열입니다. 검색 증강 생성은 원래 지식 문서 전반을 검색해 붙이는 넓은 개념인데, 여기서는 그중 처리 사례를 예시로 붙이는 쓰임에 초점을 둡니다.
엄밀히 말하면 이것은 에이전트 구조라기보다 맥락으로 제어하는 기법, 요즘 말로 컨텍스트 엔지니어링(context engineering)의 한 방법입니다. Anthropic·OpenAI·Google의 에이전트 패턴 목록에는 따로 이름이 올라 있지 않습니다. 다만 편향을 막는 위치가 “데이터”라는 점이 다른 구조와 뚜렷이 달라 함께 비교합니다.
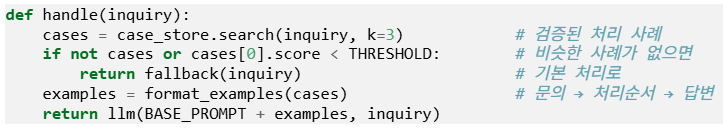
- 장점: 사례를 추가해 동작을 고칠 수 있어, 코드를 모르는 운영자도 시스템을 개선할 수 있습니다. 프롬프트가 비대해지지 않고, 새 유형도 사례를 넣으면 다룰 수 있습니다.
- 단점: 비슷한 사례가 없는 문의에는 힘을 못 씁니다(콜드 스타트, cold start). 검색이 엉뚱한 사례를 가져오면 그대로 따라 합니다. 같은 유형의 문의라도 어떤 사례가 걸리느냐에 따라 처리가 달라질 수 있어 일관성이 약합니다. 사례를 넣은 뒤 검색 결과와 처리 품질이 실제로 나아졌는지는 따로 평가해야 합니다.
- 잘 맞는 상황: 검증된 사례가 많이 쌓여 있고, 개발자가 아닌 사람이 동작을 개선해야 할 때.
4. C. 계획 후 실행 — LLM이 먼저 판단하게 한다
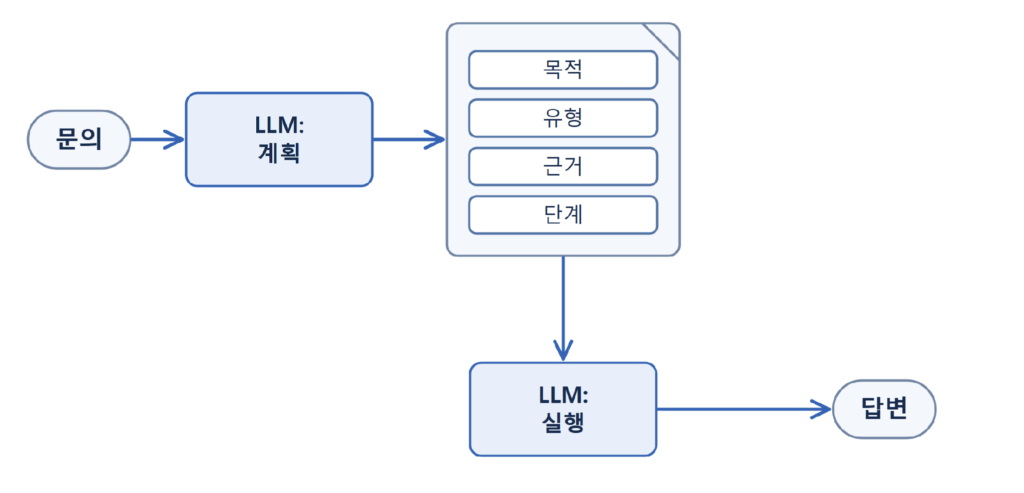
그림 5. 계획 후 실행: 목적·유형·근거·단계를 먼저 쓰고, 그 계획으로 실행한다 (필자 구성, 생성형 AI로 제작)
별도 분류기 없이, 실행 전에 LLM이 “이 문의의 목적과 유형이 무엇이고 왜 그렇게 보는가”를 명시적으로 쓰게 합니다. 계획을 먼저 세우게 하는 Plan-and-Solve 프롬프팅[8]과, 계획 수립과 실행을 나눈 Plan-and-Execute 에이전트[9]를 문의 처리에 응용한 형태입니다. 추론과 행동·관찰을 한 걸음씩 번갈아 하는 ReAct[10]와는 계획을 먼저 완성한다는 점이 다릅니다. 요청을 처리 단계로 미리 쪼개는 작업 분해(task decomposition)도 이 계획 단계에서 함께 일어납니다.
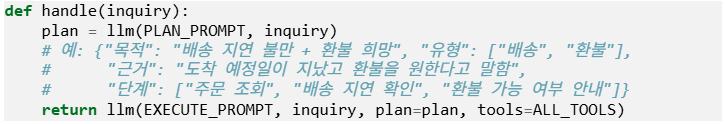
- 장점: 유형 경계가 모호하거나 여러 유형이 섞인 요청도 계획으로 풀어 처리할 수 있습니다. 분류기나 규칙을 따로 만들 필요가 없고, 왜 그렇게 판단했는지가 계획에 남습니다.
- 단점: 정확도가 모델의 추론력에 그대로 묶입니다. 계획 능력이 부족한 모델에서는 잘못된 계획이 실행으로 이어질 수 있습니다. 모델이나 프롬프트를 바꾸면 결과가 크게 흔들리고, 아래처럼 계획과 실행을 별도 호출로 나누면 호출이 하나 늘어 비용과 지연이 커집니다.
- 잘 맞는 상황: 추론력이 강한 모델을 쓸 수 있고, 요청이 유형 하나로 깔끔하게 나뉘지 않을 때. 반대로 지금 모델이 이미 유형을 잘못 판단하고 있다면, 판단을 모델에게 더 맡기는 방향이라 위험합니다.
5. D. 전문가 에이전트 — 유형마다 전담자를 둔다
유형별로 독립된 에이전트를 두고, 각 전문가가 자기 프롬프트·도구·검증을 통째로 가집니다. 흔히 멀티 에이전트(multi-agent) 구조라고 부르는 방식입니다. 지금은 누가 흐름을 쥐느냐에 따라 두 방식으로 나뉩니다.
방식 1. 관리자형 — 관리자가 전문가를 도구처럼 부른다
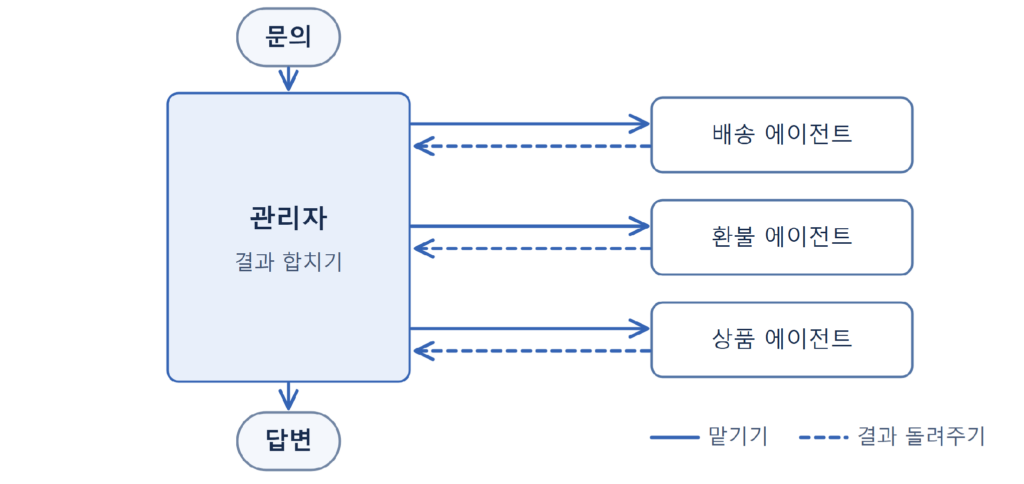
그림 6. 관리자형: 관리자가 전문가에게 일을 맡기고, 돌려받은 결과를 합친다 (필자 구성, 생성형 AI로 제작)
관리자 에이전트가 사용자와의 대화를 계속 쥐고, 전문가들을 도구처럼 불러 결과를 받아 합칩니다. Anthropic의 지휘자-작업자(orchestrator-workers) 패턴[1]과 OpenAI 가이드의 관리자(manager) 패턴[3]이 이쪽입니다. Google의 에이전트 개발 도구(ADK, Agent Development Kit)가 제공하는 조정자(coordinator) 패턴[4]은 전문가를 도구로 부르는 방식과 제어권을 넘기는 방식을 모두 지원하는데, 그중 도구로 부르는 쪽이 관리자형에 해당합니다.
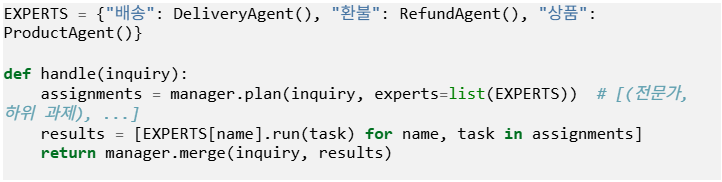
방식 2. 넘기기형 — 대화 자체를 담당자에게 넘긴다
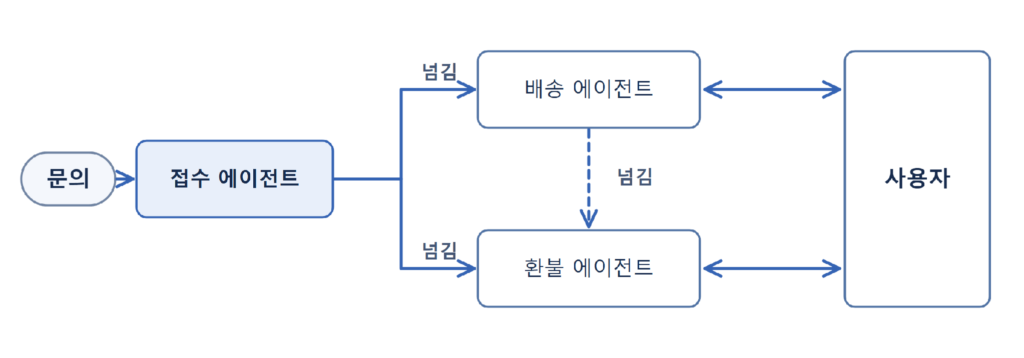
그림 7. 넘기기형: 대화를 넘겨받은 담당 에이전트가 사용자와 직접 대화한다 (필자 구성, 생성형 AI로 제작)
접수(트리아지, triage) 에이전트가 문의를 보고 대화의 주도권 자체를 담당 에이전트에게 넘깁니다. 그 뒤로는 담당자가 사용자와 직접 대화하고, 필요하면 또 다른 담당자에게 넘깁니다. 상담 전화를 담당 부서로 돌려 주는 것과 같습니다. OpenAI 가이드는 이 방식을 분산(decentralized) 패턴이라 부르고 넘기는 동작을 핸드오프(handoff)라고 하며, 바로 “주문이 어디쯤 왔나요?” 같은 문의를 접수 에이전트가 주문 담당에게 넘기는 예로 설명합니다[3]. LangChain이 만든 오픈소스 에이전트 프레임워크인 LangGraph에서는 langgraph-swarm 패키지가 이 방식을 지원합니다[11]. 아래는 OpenAI 가이드의 예제 구조를 단순화한 의사코드입니다.
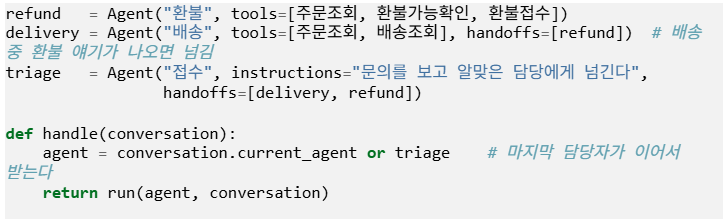
두 방식의 공통 장단점
- 장점: 격리가 강합니다. 유형별 지침과 구현이 서로 덜 얽혀, 환불 에이전트를 고칠 때 배송 에이전트를 건드릴 일이 줄어듭니다. 다만 공유 도구나 넘기기 규칙을 통한 영향은 남으니 함께 시험해야 합니다. 유형별로 따로 깊게 다듬을 수 있습니다. 관리자형은 결과를 한곳에서 합칠 수 있고, 넘기기형은 담당자가 사용자와 직접 길게 대화할 수 있습니다.
- 단점: 지휘 로직이 복잡해지고, 전문가끼리 같은 로직(주문 조회 등)이 중복됩니다. LLM 호출이 늘어 비용과 지연이 커집니다. 관리자형은 관리자가 병목이 되고, 넘기기형은 에이전트끼리 일을 주고받으며 맴돌 때 원인을 찾기 어렵습니다.
- 잘 맞는 상황: 유형별 처리 로직이 깊고 서로 독립적일 때. 관리자형은 답을 한곳에서 합쳐야 할 때, 넘기기형은 상담 전환처럼 담당자가 대화를 이어받아야 할 때 맞습니다. 다만 OpenAI 가이드는 단일 에이전트의 능력을 먼저 최대한 끌어올리고, 지침이 조건문으로 복잡해지거나 도구를 자꾸 잘못 고를 때 나누라고 권합니다[3].
6. E. 선언적 제약·가드레일 — 허용된 것만 가능하게 한다
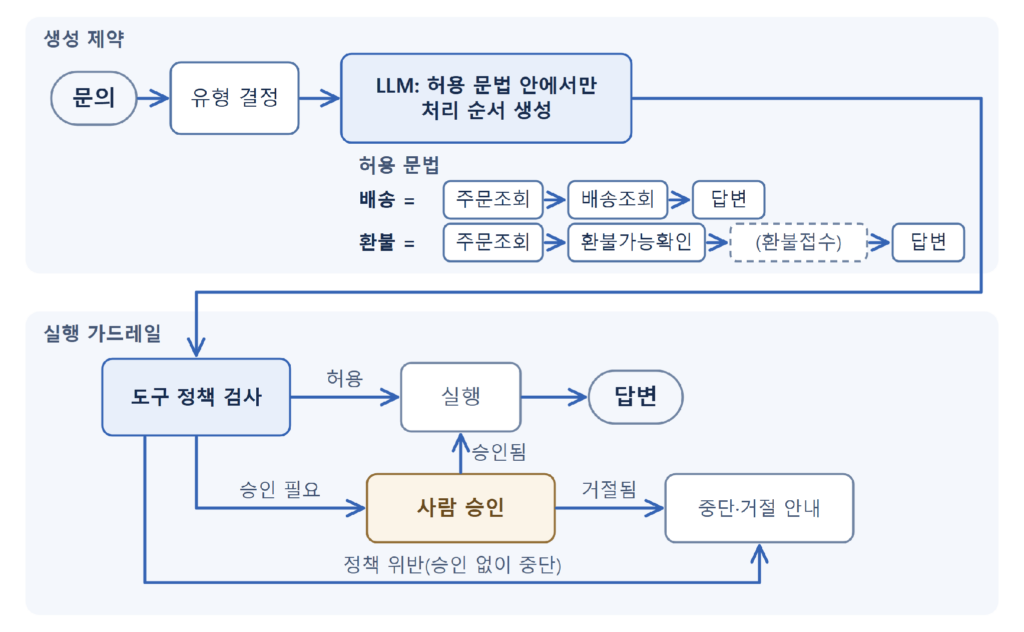
그림 8. 선언적 제약·가드레일: 허용 문법 안에서만 처리 순서를 만들고, 실행 전에 정책으로 거른다 (필자 구성, 생성형 AI로 제작)
자연어로 “하지 마세요”라고 부탁하는 대신, 구조적으로 불가능하게 만드는 방식입니다. 두 층이 있습니다.
- 생성 제약: 유형별로 허용되는 처리 순서를 문법이나 스키마로 선언하고, LLM은 그 안에서만 결과를 만들게 합니다. 제약 디코딩(constrained decoding, 예: Outlines[12]), JSON(JavaScript Object Notation) 스키마를 강제하는 구조화된 출력(structured output), 도메인 특화 언어(DSL, Domain-Specific Language) 생성이 이 계열입니다.
- 실행 가드레일(guardrail): 만들어진 행동을 실행하기 전에 정책으로 거릅니다. 도구별 허용 조건, 출력 검증, 그리고 되돌릴 수 없는 행동 앞의 사람 승인이 여기에 속합니다. 사람이 판단 고리 안에 들어간다는 뜻에서 흔히 사람 개입(HITL, Human-in-the-Loop)이라고 부릅니다. OpenAI 가이드는 큰 금액 환불 같은 고위험 행동에 사람의 확인을 두라고 권하고[3], Google ADK에도 도구 호출 전에 사용자 확인을 요구하는 정책 패턴이 있습니다[4].
두 층의 강제력은 같지 않습니다. 문법과 코드로 짠 정책 검사는 규칙대로 반드시 막지만, 사람 승인은 사람의 판단이라 오류가 남을 수 있습니다.
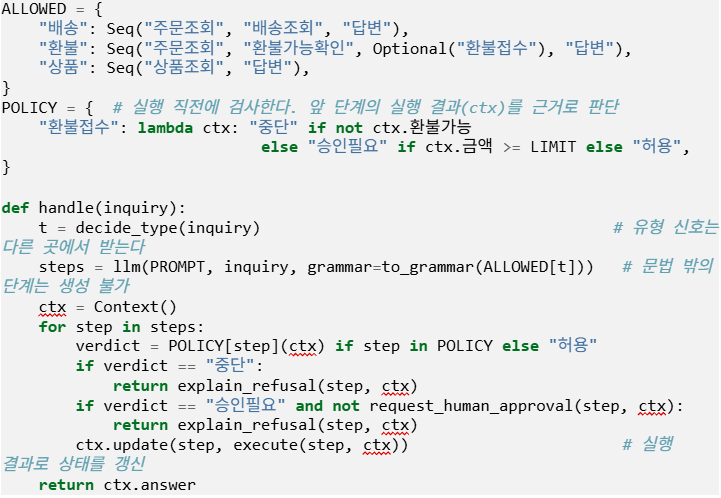
- 장점: 정의한 허용 범위 밖의 행동을 강제로 막을 수 있습니다. 배송 유형으로 판단된 문의라면 환불 접수 단계는 애초에 만들어지지 않습니다. 허용 범위가 규칙으로 정해지므로 그 범위를 벗어나는 행동은 확실히 막을 수 있고, 이미 검증 코드가 있다면 그것을 재사용할 수 있습니다.
- 단점: 문법과 정책을 정의하는 비용이 크고, 새 처리 패턴이 생길 때마다 고쳐야 합니다. 너무 좁게 잡으면 정당한 변형까지 막습니다. 제약은 허용 범위만 정할 뿐, 그 안에서 고른 단계와 답변이 맞는지는 보장하지 않습니다. 그리고 위 코드처럼 유형을 무엇으로 정할지는 E가 풀어 주지 않습니다. 유형을 잘못 판단하면 엉뚱한 문법이 적용되니, 다른 구조와 함께 써야 합니다.
- 잘 맞는 상황: 잘못된 행동의 비용이 클 때(돈이 나가는 환불 접수처럼), 유형별 처리 순서가 뚜렷하고 잘 바뀌지 않을 때.
7. F. 사후 검토 — 만든 뒤에 다른 눈으로 본다
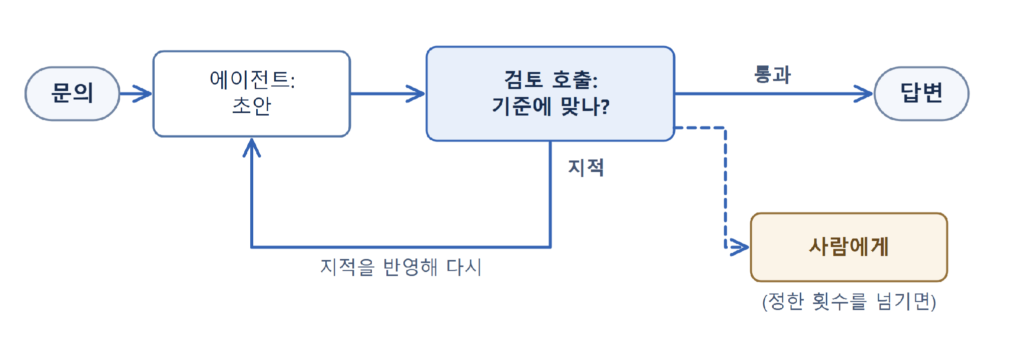
그림 9. 사후 검토: 검토를 통과할 때까지 고치고, 정한 횟수를 넘기면 사람에게 넘긴다 (필자 구성, 생성형 AI로 제작)
에이전트가 만든 결과를 별도의 검토 호출로 기준에 비춰 보고, 문제가 있으면 지적과 함께 돌려보내 고치게 합니다. 생성과 검토에 같은 모델을 써도 되고 다른 모델을 써도 됩니다. LLM에게 기준을 주고 판정을 맡긴다는 점에서, 평가에 흔히 쓰는 판정자 LLM(LLM-as-a-Judge)과 같은 발상입니다.
Anthropic의 평가자-최적화기(evaluator-optimizer) 패턴[1], Google ADK의 생성 후 검토(generate-and-review)와 반복 개선(iterative refinement) 패턴[4], 앤드루 응(Andrew Ng)이 꼽은 성찰(reflection) 패턴[13]이 이 계열입니다. 다른 구조들이 생성 전이나 중에 막는다면, 이 구조는 생성 뒤에 막습니다.
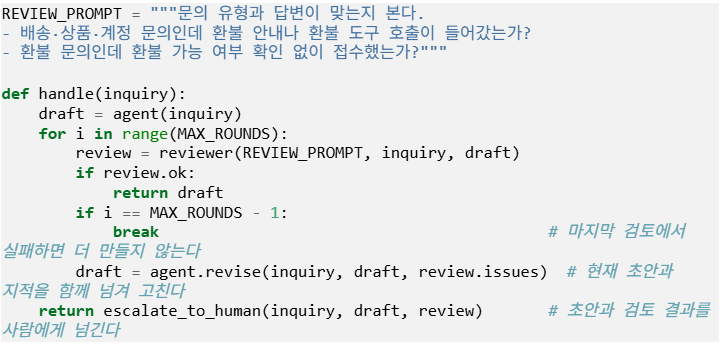
- 장점: 기존 에이전트를 거의 고치지 않고 덧붙일 수 있고, 다른 어떤 구조와도 결합됩니다. “무엇이 잘못인가”를 검토 기준이라는 글로 명시적으로 관리할 수 있습니다.
- 단점: 검토와 재작성 왕복만큼 호출과 지연이 늘어납니다. 검토자도 LLM이라 틀릴 수 있습니다. 그리고 이미 실행된 행동은 되돌리지 못합니다. 환불 접수처럼 외부에 영향을 주는 도구라면 검토를 답변 뒤가 아니라 실행 전에 둬야 하고, 그 지점에서는 E의 실행 가드레일과 역할이 겹칩니다.
- 잘 맞는 상황: 이미 돌아가는 에이전트의 품질을 크게 고치지 않고 올리고 싶을 때, 잘못을 글로 된 기준으로 판별할 수 있을 때.
8. 한눈에 비교
이 표는 측정값이나 실험값이 아닙니다. 각 구조의 작동 방식을 바탕으로 필자가 판단한 일반적인 경향을 정리한 것입니다. 특정 제품이나 데이터로 잰 결과가 아니고, 같은 구조라도 모델, 데이터, 구현 방식에 따라 얼마든지 달라집니다. 구조를 고를 때는 출발점으로만 쓰고, 자기 서비스의 대표 요청으로 직접 시험해 본 뒤 정하시기 바랍니다.
| 항목 | A 라우터 | B 사례 기반 | C 계획 후 실행 | D 전문가 | E 제약·가드레일 | F 사후 검토 |
|---|---|---|---|---|---|---|
| 제어의 위치 | 분류 + 유형별 지침 | 데이터(사례) | 모델의 추론 | 유형별 에이전트 | 구조 규칙·정책 | 생성 뒤 검토자 |
| 처리 경로 통제 | 강한 편(규칙 분류면 경로가 고정됨)~보통(모델 분류) | 약한 편 | 약한 편 | 보통 | 강한 편(허용 범위 밖의 경로를 막음) | 보통 |
| 모델 성능 의존 | 낮은 편~보통 | 보통(검색 품질과 사례를 따르는 능력) | 높은 편 | 보통 | 낮은 편(유형 판단은 다른 구조에 맡김) | 보통 |
| 모호·복합 요청 대응 | 약한 편 | 보통 | 강한 편 | 관리자형은 보통, 넘기기형은 인계 설계에 좌우됨 | 약한 편 | 보통 |
| 새 유형을 더할 때 고칠 곳 | 지침과 분류 규칙 | 사례 | 프롬프트(거의 없음) | 전문가 에이전트와 배정·인계 설정 | 문법과 정책 | 검토 기준(처리는 기존 흐름이 맡음) |
| 위험한 행동 차단 | 약한 편 | 약한 편 | 약한 편 | 보통(도구를 나눠 범위를 좁힘) | 강한 편 | 실행 전에 두면 보통, 답변 뒤면 없음 |
| 문제 추적 | 쉬운 편(분류 결과가 남음) | 보통(검색된 사례를 봄) | 보통(계획이 남음) | 어려운 편(에이전트 사이 왕복) | 쉬운 편(걸린 규칙이 남음) | 보통(지적이 남음) |
| 추가 작업과 지연 요인 | 분류 1번(규칙이면 거의 없음) | 사례 검색 1번 | 계획 호출 1번 이상 | 전문가 호출, 결과 합치기·넘기기 | 문법·정책 검사, 필요하면 승인 대기 | 검토·재작성 왕복 |
| 도입 난이도 | 낮은 편 | 보통(사례 저장소·검색 필요) | 보통 | 높은 편 | 높은 편 | 낮은 편 |
각 항목은 일반적으로 이렇게 봅니다.
- 처리 경로 통제: 요청이 어떤 경로(지침, 도구, 처리 순서)로 처리될지를 미리 정하거나 제한할 수 있는 정도입니다. 판단을 규칙과 코드가 하면 강하고, 모델이 하면 약해집니다. 경로를 정해도 그 안에서 만드는 답변까지 고정되지는 않습니다.
- 모델 성능 의존: 판단을 모델에게 얼마나 맡기느냐로 갈립니다. 모델이 강해지면 C와 스킬 변형의 약점이 줄고, 약한 모델을 써야 하면 규칙과 구조로 받치는 A·E가 유리합니다. 다만 E는 유형 판단을 스스로 하지 않으므로, 유형을 정하는 앞 구조의 성능에 함께 묶입니다.
- 모호·복합 요청 대응: 한 번에 유형 하나만 고르는 구조는 약하고, 판단을 글로 풀어 쓰거나 여러 지침을 함께 쓸 수 있는 구조는 강합니다.
- 새 유형을 더할 때 고칠 곳: 고칠 곳이 적을수록 좋지만, 누가 고칠 수 있는지(개발자인지 운영자인지)와 고친 뒤 무엇을 다시 시험해야 하는지도 함께 봐야 합니다.
- 위험한 행동 차단: 확률적으로 판단하는 모델 바깥에, 코드로 막는 장치가 있느냐가 기준입니다. 지침이나 예시로 부탁하는 것만으로는 막는다고 보기 어렵습니다.
- 문제 추적: 잘못된 답이 나왔을 때 “어느 단계에서 틀렸는가”를 기록으로 짚을 수 있는 정도입니다. 판단이 한곳에 모이고 그 결과가 남을수록 쉽습니다.
- 추가 작업과 지연 요인: 모델 호출 수만 보면 안 됩니다. 검색, 입력 길이, 도구 실행, 사람 승인 대기도 전체 비용과 지연에 들어갑니다. 그래서 횟수 대신 무엇이 더해지는지를 적었습니다.
A의 스킬 변형은 기본형과 몇 칸이 다릅니다. 처리 경로 통제는 약한 편, 모델 성능 의존은 보통~높은 편, 모호·복합 요청 대응은 강한 편이고, 새 유형은 스킬 문서 하나를 더하면 됩니다. 분류를 모델에게 맡기는 만큼 C(계획 후 실행) 쪽 성질을 일부 띱니다.
9. 상황별 선택 가이드
정답 구조는 없습니다. 팀이 처한 조건에 따라 우선순위가 달라집니다.
| 이런 조건이라면 | 먼저 볼 구조 | 이유 |
|---|---|---|
| 아직 시작 단계이고 유형이 뚜렷하다 | A (기본형 또는 템플릿) | 기존 프롬프트를 유형별로 쪼개는 것에서 바로 시작할 수 있다 |
| 쓰는 모델의 유형 판단이 자주 틀린다 | A(규칙 분류), E | 판단을 모델에 덜 맡기고 규칙과 구조로 받친다. 스킬 변형과 C는 대표 문의로 먼저 시험해 본 뒤 고른다 |
| 절차가 많고 계속 늘며, 판단력 있는 모델을 쓴다 | A의 스킬 변형 | 맥락은 가볍게 유지하면서 문서만 추가하면 된다 |
| 검증된 처리 사례가 많고, 운영자가 개발자가 아니다 | B | 사례를 넣는 것이 곧 개선이 된다 |
| 여러 유형이 섞인 요청이 많고, 강한 모델을 쓸 수 있다 | C (또는 A의 스킬 변형) | 경계가 모호한 요청을 유연하게 다룬다 |
| 유형마다 로직이 깊고 팀도 유형별로 나뉜다 | D 관리자형 | 격리와 독립적인 개선의 이점이 복잡도를 넘어선다 |
| 담당자가 대화를 이어받아야 한다(상담 전환) | D 넘기기형 | 넘긴 뒤에는 담당자가 사용자와 직접 대화한다 |
| 잘못된 행동 하나의 비용이 크다 | E (다른 구조 위에 안전망으로) | 확률적으로 틀려도 마지막에 구조와 사람이 막는다 |
| 이미 돌아가는 에이전트를 크게 고치지 않고 품질을 올리고 싶다 | F | 기존 흐름 뒤에 덧붙이면 된다 |
10. 섞어 쓰기: 결합하기 쉬운 것과 전환이 필요한 것
실제로는 한 구조만 쓰기보다 섞어 쓰는 경우가 많습니다. 이때 알아 둘 점이 하나 있습니다.
A·B·E·F는 기존 흐름에 덧붙이는 방식이라 비교적 쉽게 결합됩니다. 예를 들면 이렇습니다.
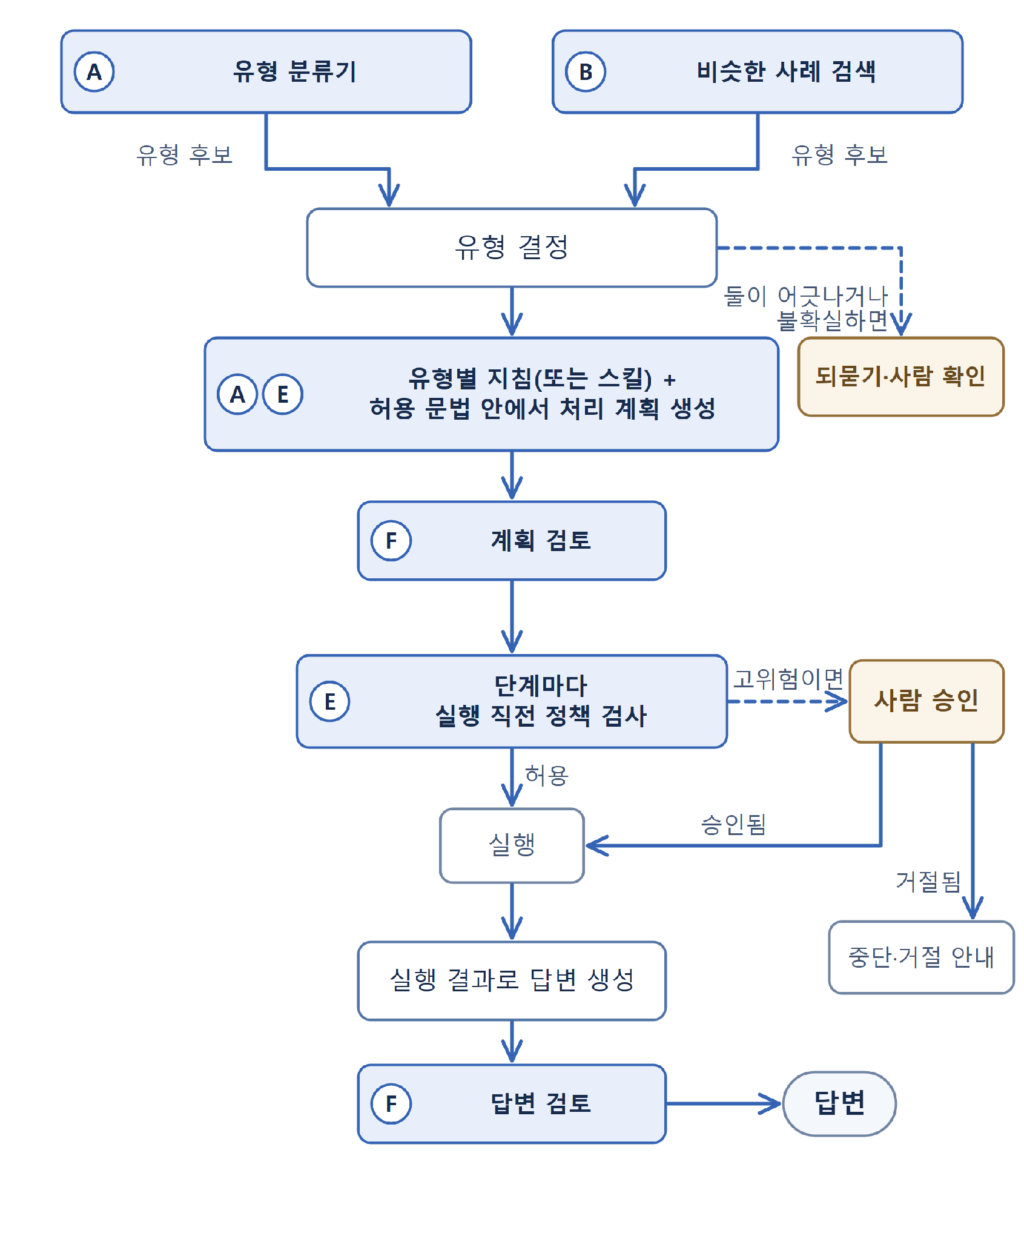
그림 10. 섞어 쓰기의 예: 분류와 사례로 유형을 정하고, 계획·답변 검토와 실행 전 정책 검사를 더한다 (필자 구성, 생성형 AI로 제작)
- A가 뼈대를 맡고, B가 데이터로 A의 분류 한계를 메우고, F가 계획과 답변을 다시 보고, E가 실행 직전의 안전망이 됩니다.
- 앞에서 본 E의 약점(유형을 스스로 정하지 못함)은 A·B가 유형 후보를 주면서 보완됩니다. 두 신호가 어긋나거나 확신이 낮으면 고객에게 되묻거나 사람에게 넘깁니다.
반면 C와 D는 상대적으로 큰 구조 전환입니다. C는 판단의 주체를 규칙에서 모델로 옮기는 일이고, D는 시스템을 여러 에이전트로 다시 나누는 일입니다. 물론 결합 비용은 기존 구조에 따라 달라서, C도 계획 단계 하나를 앞에 더하는 정도로 가볍게 시작할 수는 있습니다. 그래도 전면 도입은 시점을 신중히 고르는 것이 좋습니다. 예를 들어 C는 더 강한 모델로 바꾸는 시점에, D는 유형이 크게 늘고 팀이 나뉘는 시점에 다시 검토할 만합니다.
마치며
에이전트가 엉뚱한 방향으로 기울 때, 프롬프트에 금지 문장을 하나 더 붙이기 전에 먼저 이렇게 물어볼 만합니다.
이 편향을 어디서 막을 것인가? 분류와 지침인가, 사례인가, 모델의 추론인가, 전문가인가, 구조와 정책인가, 사후 검토인가?
이 질문에 답하면 지금 필요한 구조와, 나중에 바꿔야 할 시점이 함께 보입니다. 유형 경계가 뚜렷하다면 라우터로 시작하는 것이 무난합니다. 그 위에 사례가 쌓이면 사례 기반을 얹고, 절차가 많아지면 라우터를 스킬 방식으로 바꿉니다. 결과 품질은 사후 검토로, 위험한 행동은 제약과 사람 승인으로 막습니다. 모델이 충분히 강해지거나 조직이 커지면 그때 계획 후 실행과 전문가 에이전트를 다시 꺼내 보면 됩니다.
참고 자료
- Anthropic, “Building effective agents”, 2024-12-19. https://www.anthropic.com/engineering/building-effective-agents — 라우팅, 지휘자-작업자, 평가자-최적화기 패턴
- Anthropic, “Equipping agents for the real world with Agent Skills”, 2025-10-16. https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills — 스킬과 점진적 공개
- OpenAI, “A practical guide to building agents”, 2025-04. https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf — 단일 에이전트 우선, 프롬프트 템플릿, 관리자·분산(핸드오프) 패턴, 가드레일과 사람 개입
- Google, Agent Development Kit 멀티 에이전트 패턴. https://adk.dev/workflows/patterns/ — 조정자, 생성 후 검토, 반복 개선, 사람 개입 패턴
- Aurelio Labs, semantic-router. https://github.com/aurelio-labs/semantic-router — 임베딩 기반 라우팅 라이브러리
- Lewis et al., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, NeurIPS 2020. https://arxiv.org/abs/2005.11401 — 검색 증강 생성
- Liu et al., “What Makes Good In-Context Examples for GPT-3?”, 2021. https://arxiv.org/abs/2101.06804 — 비슷한 예시를 골라 붙이는 소수 예시 선택
- Wang et al., “Plan-and-Solve Prompting”, ACL 2023. https://arxiv.org/abs/2305.04091
- LangChain, “Plan-and-Execute Agents”, 2023-05-10. https://www.langchain.com/blog/plan-and-execute-agents
- Yao et al., “ReAct: Synergizing Reasoning and Acting in Language Models”, 2022. https://arxiv.org/abs/2210.03629
- LangChain, langgraph-swarm. https://github.com/langchain-ai/langgraph-swarm-py — 에이전트 간 넘기기를 지원하는 LangGraph 기반 패키지
- dottxt-ai, Outlines. https://github.com/dottxt-ai/outlines — 문법·스키마로 생성을 제약하는 라이브러리
- Andrew Ng, “Agentic Design Patterns Part 2, Reflection”, The Batch, 2024-03-27. https://www.deeplearning.ai/the-batch/agentic-design-patterns-part-2-reflection/
- Agent Skills 공개 표준 문서. https://agentskills.io/ — 스킬 형식 명세와 지원 도구 목록(2025-12-18 공개)