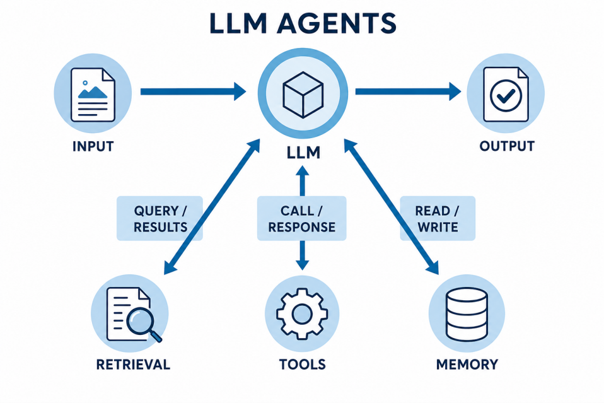
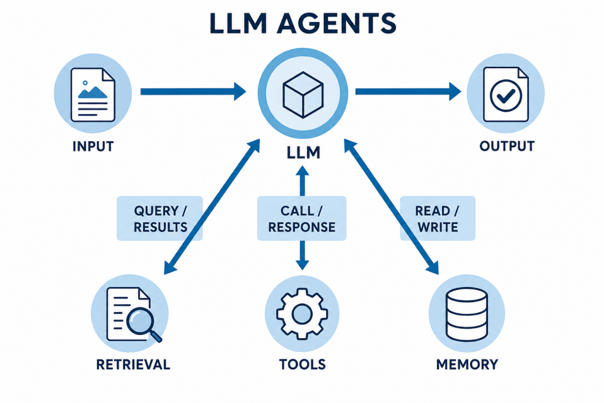
LLM 에이전트 도구 호출 다이어그램
인트로
사내 챗봇은 단순한 질문에 답할 뿐, 스스로 판단하여 보고서를 쓰거나 신청서를 검토하는 ‘자율형 에이전트’의 역할을 대신할 수 없다. 많은 조직이 에이전트를 도입하고자 거대한 데이터 인프라 구축부터 시작하지만, 가시적인 성과 없이 예산과 인내심만 소진하기 일쑤이다.
본 기사는 복잡한 백엔드 공사 대신, 이미 사용 중인 오피스 도구(Notion, Google Workspace)를 에이전트의 지식 창고와 장기 기억으로 활용하는 실용적인 아키텍처를 제안한다. 무거운 인프라 없이 즉각적인 비즈니스 가치를 창출하고 실무자가 투명하게 통제할 수 있는 효율적인 에이전트 설계 패턴을 확인해 보시기 바란다.
1. 서론: AI가 실제로 일을 하게 만들려면
사내 챗봇은 질문에 답할 뿐, 실제로 신청서를 검토하거나 보고서를 쓰지는 않는다. 에이전트는 이 간극을 좁힌다. RPA가 정해진 대본을 반복한다면, 에이전트는 “주간보고서를 써줘” 같은 목표를 받아 어떤 자료를 볼지, 무엇이 성과이고 문제인지를 스스로 판단한다.
문제는 LLM에게 우리 회사 데이터를 볼 눈도, 문서를 고칠 손발도 없다는 점이다. “데이터 인프라부터 구축하라”는 조언이 흔히 따라오지만, 이 길은 6개월~1년이 걸리고 그동안 눈에 보이는 성과가 없어 예산과 인내심이 먼저 떨어지는 경우가 많다.
이 글은 다른 출발점을 제안한다. 이미 쓰고 있는 Notion, Google Docs, Sheets를 에이전트의 눈과 기억으로 쓰는 것이다. 이 도구들은 API가 있고, 무엇보다 개발자가 아닌 사람도 직접 열어볼 수 있다. 이 특성이 뒤에서 계속 중요해진다. 예시로는 팀 주간보고서를 Notion에서 모아 Google Docs로 발행하는 에이전트를 사용한다.
| 거창한 백엔드 인프라나 사내 관리자 페이지를 새로 구축할 필요가 없다. 매일 쓰는 오피스 생태계의 편집 화면(Head)을 떼어내고 API를 연결하는 순간, 훌륭한 사내용 Headless CMS가 탄생하기 때문이다. |
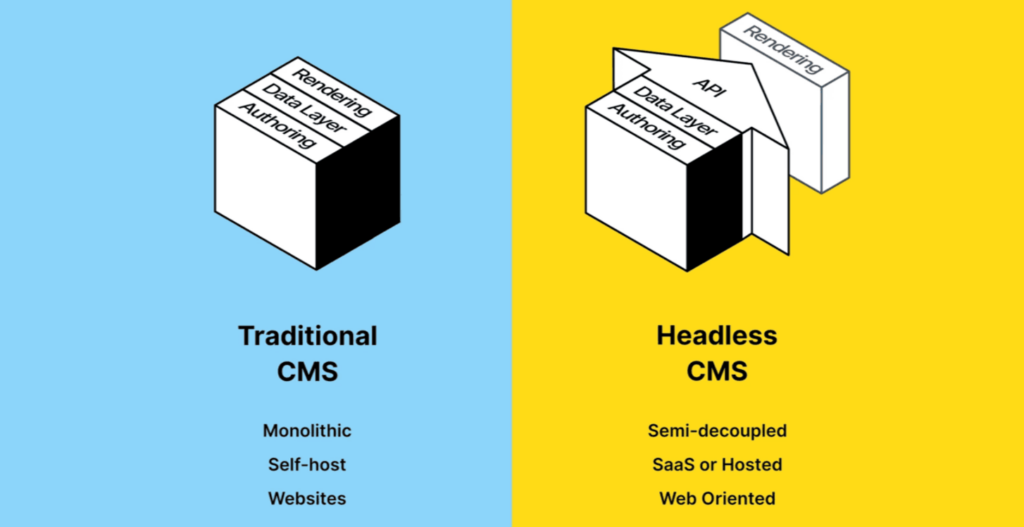
[그림 1] Headless CMS (“콘텐츠를 작성하는 곳(입력)”과 “콘텐츠를 사용하는 곳(출력/표현)”)
2. 에이전트의 두뇌: 계획, 실패, 재계획
“오늘 날씨 알려줘”처럼 요청 하나에 함수 하나가 대응되는 걸 Function Calling이라 한다. 반면 “주간보고서를 만들어줘”는 여러 단계가 필요하다. Notion 조회 → AI 요약 → 문서 작성 → 상태 기록. 각 단계의 결과가 다음 단계의 입력이 된다.
이럴 때는 바로 실행하지 말고 무엇을 어떤 순서로 할지 먼저 계획을 세우게 하되, JSON처럼 정해진 형식으로 받는 게 핵심이다. 실행 전에 코드로 검사할 수 있기 때문이다.
실패는 예외로 던지지 말고, 정보로 돌려주어야 한다. 실제로 이 에이전트를 운영하며 겪은 일이다.
매주 새 문서를 만들려고 Google Docs를 복사했더니 403 storageQuotaExceeded 에러가 났다. 구글 서비스 계정(로봇 계정)은 공유 드라이브 없이는 자기 소유 용량이 사실상 0바이트이기 때문이다. 여기서 그냥 죽이는 대신 “복사는 실패했지만 기존 문서는 살아 있다”는 사실을 다음 판단의 재료로 쓴다. 재계획은 이 정보를 받아 “그럼 매주 새 문서를 만들지 말고, 기존 문서 하나에 표를 계속 추가하자”로 전략을 바꾸는 것이다. (이 결과물은 3장에서 자세히 다룬다.)
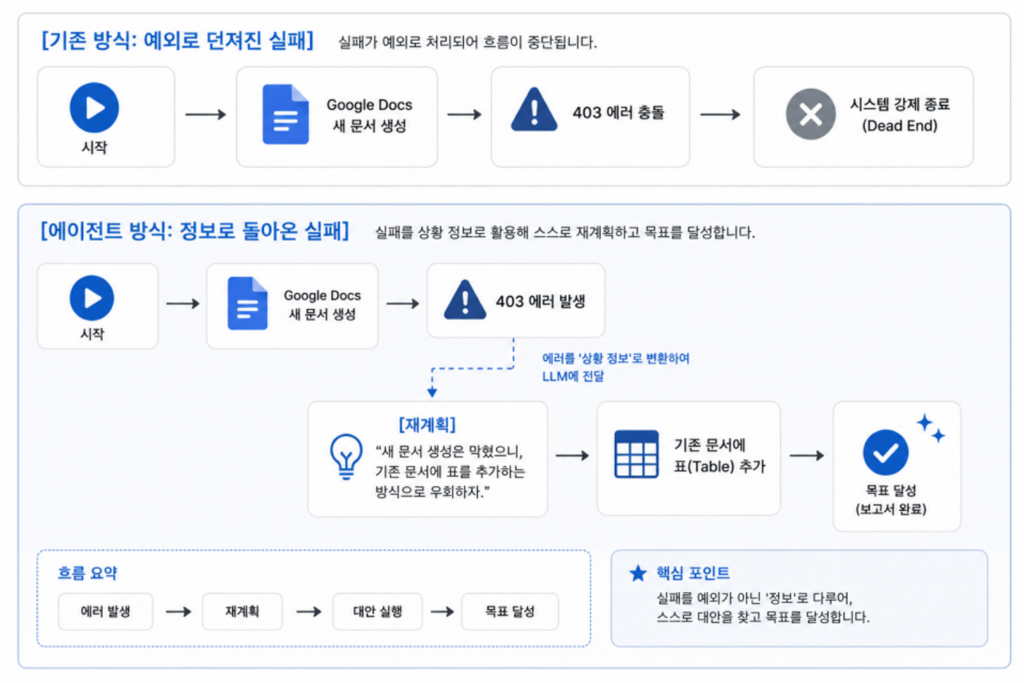
[그림 2] 에이전트의 자가 수정 및 동적 재계획
에이전트를 처음 만들 때 가장 흔한 실수는 쓸 수 있는 함수를 전부 등록하는 것이다. 도구가 많을수록 AI는 엉뚱한 걸 고른다.
- 단계별로 필요한 도구만 노출한다. 수집 단계엔 조회 도구만, 작성 단계엔 쓰기 도구만.
- 업무 단위로 묶는다. get_row / update_cell을 따로 주지 말고 mark_report_ready(week, doc_url) 하나로 묶으면 실수할 여지가 줄어든다.
- 같은 작업을 두 번 해도 안전하게(멱등성) 만든다. 에이전트는 재시도가 잦아서 같은 도구가 두 번 불릴 수 있고, 메일이 두 번 나가는 사고는 거의 여기서 나온다.
3. 오피스 도구를 지식과 기억으로
사내 에이전트의 상당수는 Vector DB 없이도 잘 돌아간다.
Drive를 그대로 지식 창고로. RAG는 보통 문서를 잘게 쪼개(청킹) 임베딩하고 Vector DB에 저장하는 방식이다. 이건 문서가 아주 많을 때 유효한 전제이다. 반대로 봐야 할 문서가 여비 규정 PDF 한 개뿐이라면, 통째로 프롬프트에 넣는 게 오히려 더 정확하다. 청킹은 “숙박비 한도 8만 원, 단 제12조 지역은 예외”처럼 붙어 있어야 할 조건과 예외를 잘라버릴 수 있기 때문이다. Drive에서 최신 파일을 매번 불러오면(ETag로 변경 감지) 원본이 하나로 유지되어, 재색인도 “왜 작년 규정을 인용하지?” 같은 디버깅도 필요 없다.
Sheets를 상태 저장소로. 에이전트가 “어디까지 했는지” 기억하려면 상태가 필요하다. DB에 넣어도 되지만 실무자에겐 블랙박스가 된다. 시트에 저장하면 담당자가 직접 열어보고, 셀을 고쳐서 상태를 바꿀 수 있다. 관리자 화면이나 별도 API가 필요 없다. 대신 동시 쓰기에 약하고 수천 행이 한계라, 초당 수십 건을 써야 하면 시트는 답이 아니다.
실전 예시: 주간보고서 자동화
첫 버전은 단순했다. Notion 조회 → AI 요약 → 문서 작성 → 시트 기록, 4단계로 며칠 만에 돌아갔다. 그런데 몇 주 굴려보니 2장에서 말한 용량 에러를 만났고, 구조를 다시 짰다. 지금은 이렇게 나뉜 노드들이 순서대로 실행된다.
1. FetchNotion — 지난 한 주 변경분을 가져오며 원본 페이지 URL을 함께 보관한다. 나중에 “이거 어디서 나온 얘기죠?”에 답하는 근거가 된다.
2. FetchWBS — 같은 주에 해당하는 WBS 구간을 가져온다. FetchNotion과 서로 의존하지 않으므로 동시에(병렬로) 실행해 시간을 아낀다.
3. Summarize — “요약해줘”가 아니라 출력 구조를 못 박는다. 업무일지와 WBS를 합쳐, 계획 대비 실적을 팀원별로 완료된 성과 / 진행 중 / 막힌 지점 세 범주로 강제 분류한다. 임원이 진짜 찾는 건 성과 목록이 아니라 자기가 개입할 지점이기 때문이다.
4. WriteDoc — 매주 문서를 복사하는 대신, 미리 만든 문서 1개의 맨 위에 표를 계속 추가한다. 최신 보고서가 항상 맨 위에 오고, 지난 기록은 아래로 쌓인다.
5. UpdateWBS — WriteDoc과 동시에, WBS 시트의 진척도(%)를 갱신한다. 둘 다 Summarize의 출력을 쓰지만 서로 의존하지 않는다.
6. MarkReady — WriteDoc과 UpdateWBS가 모두 끝나야만 다음 단계로 넘어간다(합류). 메일을 바로 보내지 않고, 시트의 대기열 탭에 ‘발송 대기’ 상태와 문서 링크만 기록한다.
FetchNotion이 매주 읽어오는 실제 업무일지는 이런 모습이다. 담당자별로 완료·진행 항목이 자유 텍스트로 쌓인다.
| 최종수정일 | 김철수 | 이영희 | 박민수 | 정다솜 |
| 08월 17일 | [완료] 연차 | [완료] 기술기준 섹션 분리 및 청킹 후 DB 적재 [진행] 공고 모니터링 API 수정 반영 및 프론트 연동 (90% (~8/18)) | [진행] 사례집 섹션 패턴 분할 (70% (~8/18)) | [완료] 개발환경 세팅 |
| 08월 18일 | [진행] 운영지침 섹션 분리 및 청킹 후 DB 적재 (오버랩 추가 완료, 임베딩 제외 적재. 50% (~8/20)) [완료] 공고 모니터링 코드 오류 수정 | [진행] 기술기준 재청킹 및 청킹 검증 (오버랩 추가 완료. 검증 50% (~8/19)) | [완료] 사례집 섹션 분리 고도화 및 오버랩 추가 | [완료] 인수인계 코드 및 데이터 검토 [완료] 민감정보 샘플 데이터 생성 |
| 08월 19일 | [완료] 청킹 규칙 변경에 따른 재청킹 및 통계 검증 (청크 사이즈 기준 통계 검증까지 마침) | [진행] 오버래핑 고도화 (30% (~8/20)) | [진행] 오버랩 기준 변경 후 고도화 (수정 중) | [완료] BERT 계열 4종 + Mistral-7B 추출 성능 비교 |
| 08월 20일 | [완료] 섹션 분리 코드 고도화 및 84,200건 재적재 (메타데이터 전처리 후 개발서버 반영) | [완료] 오버랩 150 / 원문 800자 기준으로 재적재 | [완료] 청킹 검증용 JSON 컬럼 추가 후 전체 재추출 | [완료] Qwen-4B 및 정규식 대비 비교 [진행] 가맹점 분류 데이터 구축 방향 검토 (30% (~8/21)) |
| 08월 21일 | [완료] 청크 사이즈 상향 후 재적재 (300→800자, 오버랩 100→150자) [완료] 제조사 AI 플랫폼 제안서 목차 배포 | [완료] 메타데이터 계층 구조화 (그래프DB용 계층 구분 완료) [진행] 청크 임베딩 (80% (~8/24)) | [진행] 분할 기준 변경 (800 ~ 1000자, 오버랩 150자) [보류] 사례집 DB 적재 (텍스트 추출 파일에서 doc_id 중복 발생. 40%에서 멈춤. 중복 처리 방침 결정 필요) | [진행] 파인튜닝용 클래스 추가 데이터 생성 (주소·생년월일 클래스 추가. 40% (~8/24)) [진행] 1차 증강 및 업종 모델 학습 (증강 완료 (1,200 → 12,000건). 학습 20% (~8/24)) |
[표 1] 업무 일지 (Notion)
같은 Notion 공간에는 프로젝트 전체 일정을 담은 WBS도 함께 있다. 선행 의존성 열에는 어떤 작업이 어떤 작업 뒤에 와야 하는지가 이미 나타나 있다.
| 대분류 (Phase) | 세부 업무 (Work Package) | 기준 시작일 | 기준 종료일 | 상태 | 선행 의존성 (DAG 엣지) |
| 1.0 환경 준비 | 1.1 개발환경 및 인프라 세팅 | 08/14 | 08/17 | 완료 | – |
| 1.2 원천 데이터 확보 및 인수인계 | 08/14 | 08/18 | 완료 | – | |
| 2.0 데이터 전처리 | 2.1 문서(지침/사례집) 구조화 및 분할 | 08/16 | 08/18 | 완료 | 1.2 완료 후 |
| 2.2 청킹 및 오버래핑 기준 고도화 | 08/19 | 08/21 | 진행 | 2.1 완료 후 | |
| 3.0 DB 및 임베딩 | 3.1 청크 임베딩 및 계층 구조화 | 08/20 | 08/24 | 진행 | 2.2 완료 후 |
| 3.2 벡터 DB(사례집 포함) 재적재 | 08/21 | 08/25 | 보류 | 2.2 완료 후 | |
| 4.0 모델 학습 | 4.1 베이스 모델 추출 성능 비교 | 08/17 | 08/20 | 완료 | 1.2 완료 후 (2.0과 병렬) |
| 4.2 파인튜닝 데이터 생성 및 모델 학습 | 08/21 | 08/25 | 진행 | 4.1 완료 후 |
[표 2] 프로젝트 WBS (Notion)
각 노드의 실행 결과는 시트에 남는다. 그래서 중간에 실행이 죽어도, 다시 돌리면 이미 성공한 노드는 시트에 저장된 결과를 그대로 불러와 건너뛰고, 실패했던 노드부터만 재개한다. 매번 전체를 다시 돌릴 필요가 없다는 뜻이다.
| 담당역할 | 금주 실적 (08.24 ~ 08.28) | 차주 계획 (08.31 ~ 09.04) |
| 데이터 수집·가공 | [완료] 청크 사이즈(800자) 및 오버랩 상향, 84,200건 재적재 완료 [완료] 기술기준/운영지침 섹션 분리 및 청킹 규칙 통계 검증 마침 [진행] 공고 모니터링 API 연동(90%) 및 사례집 패턴 분할(70%) 🚨[막힌 지점 / 보류] 사례집 DB 적재텍스트 추출 파일 doc_id 중복 발생으로 40%에서 중단. 중복 처리 방침 결정 필요. | – 중복 doc_id 예외 처리 방침 결정 및 로직 적용 후 사례집 DB 적재 재개 – 오버랩 기준 변경 후 분할 로직 고도화 완료 |
| AI 모델 학습 및 파인튜닝 | [완료] 파운데이션 모델 4종(BERT, Mistral-7B, Qwen-4B 등) 추출 성능 비교 완료 [완료] 개발환경 세팅 및 민감정보 샘플 데이터 생성 [진행] 메타데이터 계층 구조화 및 청크 임베딩 (80%) [진행] 업종 모델 1차 데이터 증강 및 학습 (20%) | – 파인튜닝용 클래스(주소, 생년월일) 데이터 생성 완료 – 가맹점 분류 데이터 구축 방향성 확정 및 본격화 |
[표 3] 주간 업무 (Google Docs) 실행 예시
[표 3]이 임원에게 보여주는 서술형 요약이라면, UpdateWBS가 실제로 쓰는 대상은 [표 2]의 WBS 시트다. Summarize가 팀원별로 분류한 결과를 이번엔 Phase 단위로 다시 집계해, WBS 시트의 진척도(%) 컬럼을 숫자로 갱신한다. 이번 주 실행 결과는 이렇게 반영된다.
| 대분류 (Phase) | 세부 업무 (Work Package) | 상태 | 갱신 전 진척도 | 갱신 후 진척도 | 근거 (Summarize 출력) |
| 2.0 데이터 전처리 | 2.2 청킹 및 오버래핑 기준 고도화 | 진행 | 60% | 80% | 이영희: 오버래핑 고도화 30% → 청크 임베딩 80% (~8/24) 박민수: 오버랩 기준 변경 후 고도화 진행 중 |
| 3.0 DB 및 임베딩 | 3.1 청크 임베딩 및 계층 구조화 | 진행 | 50% | 80% | 이영희: 청크 임베딩 80% (~8/24) |
| 3.2 벡터 DB(사례집 포함) 재적재 | 보류 | 40% | 40% (변동 없음) | 박민수: 사례집 DB 적재 40%에서 멈춤, doc_id 중복 처리 방침 결정 필요 | |
| 4.0 모델 학습 | 4.2 파인튜닝 데이터 생성 및 모델 학습 | 진행 | 20% | 40% | 정다솜: 1차 증강 완료(1,200 → 12,000건), 학습 20% (~8/24) |
[표 4] UpdateWBS 실행 예시 — WBS 시트 진척도(%) 갱신 (Notion)
WriteDoc이 이 결과를 문서 맨 위에 새 표로 쌓는 동안, UpdateWBS는 같은 Summarize 출력을 WBS 시트의 숫자 컬럼에 반영한다. 3.2처럼 “보류” 상태인 항목은 진척도를 그대로 두어, 막힌 지점이 숫자로도 드러나게 한다. 같은 입력을 서로 다른 두 곳(문서, 시트)에 쓰기 때문에 WriteDoc과 UpdateWBS는 서로 의존하지 않고 병렬로 실행된다.
4. 파이프라인 순서를 DAG로 통제하기
노드가 늘어나면 “누가 언제 실행되는가”가 문제이다. AI에게 자율성을 주어 다음 순서를 직접 정하게 하면 겉보기엔 유연해 보이지만, 실무 도입 시 세 가지 치명적인 벽에 부딪힌다. 이 문제를 해결하는 뼈대가 바로 DAG(방향성 비순환 그래프) 구조다.
- 무한 루프와 예측 불가능한 비용 방지: AI는 “정보가 부족하다”고 판단하면 수집과 요약을 끝없이 반복하는 ‘루프’에 빠지기 쉽다. 순환이 원천 차단된 일방통행 화살표(DAG)는 이 과금 폭탄을 막는 가장 확실한 안전장치다.
- 병렬 처리를 통한 속도 최적화: 업무일지와 WBS 데이터를 순서대로 읽으면 10초가 걸리지만, 서로 의존성이 없는 작업을 병렬 노드로 묶으면 시간은 절반으로 단축된다.
- 체크포인트를 통한 부분 재시도: 에이전트가 마지막 단계에서 네트워크 에러로 멈췄을 때, 처음부터 다시 요약하며 비싼 API 토큰을 태울 필요가 없다. DAG는 각 노드의 성공 상태를 기억하므로, 실패한 노드부터 정확히 재개할 수 있다.
요리 레시피에서 “썬다 → 볶는다”는 있어도 “볶은 뒤 다시 썬다”가 없는 것과 같다. 주간보고서 파이프라인도 마찬가지다. FetchNotion과 FetchWBS는 서로 의존하지 않으므로 동시에 실행되고, WriteDoc과 UpdateWBS도 같은 Summarize 결과를 각자 다른 곳에 쓰는 병렬 작업이다. MarkReady는 이 둘이 모두 끝나야 시작되는 합류 지점이다. 그래프로 그리면 이렇게 된다.
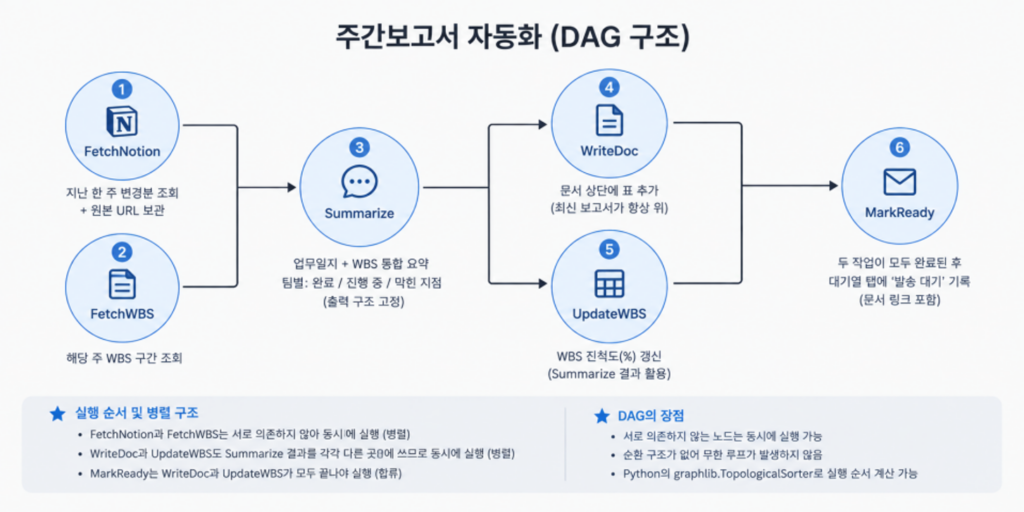
[그림 3] 에이전트 기반 주간보고서 자동화
서로 의존하지 않는 FetchNotion과 FetchWBS, 또는 WriteDoc과 UpdateWBS 같은 노드는 동시에 실행할 수 있고, 순환 자체가 구조적으로 막혀 무한 루프가 생기지 않는다. 파이썬 표준 graphlib.TopologicalSorter로 이 순서를 계산할 수 있다.
역할을 나눌 때 한 가지는 꼭 지킨다. 자기가 만든 결과를 자기가 검토하게 하지 않는다. 같은 대화 안에서 “네가 쓴 거 검토해봐”라고 하면 대개 “잘 작성됐습니다”가 돌아온다. 검토는 별도의 깨끗한 컨텍스트에서 해야 한다.
실무 권장은 바깥 뼈대는 DAG로 고정해 시간과 비용의 상한을 보장하고, 재시도는 노드 안에서만, 횟수를 제한해서 허용하는 것입니다. 비용을 예측할 수 없는 시스템은 프로덕션에 올릴 수 없다.
5. 안전장치와 운영, 그리고 결론
읽기는 틀려도 복구되지만, 쓰기는 되돌릴 수 없다. 잘못된 문서를 읽었으면 다시 읽으면 되지만, 잘못된 메일은 취소 메일로 회복되지 않는다. 원칙은 단순하다. 읽기는 넓게, 쓰기는 좁게 통제한다.
체크박스로 만드는 승인 게이트 에이전트가 준비를 마치면 바로 보내지 않고, 시트에 ‘발송 대기’ 행과 빈 승인 체크박스를 기록한다. 담당자가 확인하고 체크하면 다음 주기에 발송된다.
| def send(row_id): row = sheet.get_row(row_id) if not row[“approved”]: # 프롬프트가 아니라 코드로 막는다 return {“status”: “blocked”} return mail.send(…) |
프롬프트에 “승인 없이 보내지 마”라고 적는 것과는 다르다. 프롬프트 제약은 확률이라, 99%를 지켜도 100번에 한 번은 사고가 난다. 차단이 코드에 있어야 100%가 된다.
무슨 일이 있었는지 기록한다. 각 노드의 입력, AI 응답, 소요 시간, 토큰 사용량을 남긴다. 토큰 사용량은 비용 지표가 아니라 조기 경보이다. 어떤 노드가 평소의 3배를 쓰면 대개 불필요한 데이터가 섞여 들어가고 있다는 뜻이고, 품질이 떨어지기 전에 숫자가 먼저 움직인다.
결론. 에이전트는 연결되어야 가치를 만들고, 그 연결 대상은 새로 지을 필요가 없다. 상태가 투명하면 개입이 쉽고, 개입이 쉬우면 신뢰가 쌓인다. 전사 인프라 계획서를 쓰기 전에, 한 팀의 반복 업무 하나를 골라 몇 주 안에 돌아가는 에이전트를 만들어 본다. Vector DB도 오케스트레이션 플랫폼도 필요해지면 그때 쓰면 된다. 인프라부터 짓는 조직은 대개 인프라만 남기고 끝난다.
참고문헌
l https://gojimin.com/posts/headlesscms
l Andrew Ng, “Agentic Design Patterns Part 1~4”, DeepLearning.AI (2024) LangChain, “LangGraph: Multi-Actor, Stateful Applications with LLMs”, LangChain Blog
l Shunyu Yao et al., “ReAct: Synergizing Reasoning and Acting in Language Models”, ICLR (2023)