들어가며
LLM Agent는 도구가 필요한 질문에서만 확실히 RAG를 이겼고, 규정만 묻는 질문에서는 RAG로 충분했다. 30개 질문으로 직접 비교해 얻은 결과다.
사내 규정 챗봇을 만들다 보면 “이제 RAG 말고 Agent를 써야 하나?”라는 질문이 나온다. 이 글은 그 질문에 감이 아니라 숫자로 답해 보려는 기록이다. 같은 모델(gpt-4o-mini)로 먼저 RAG-only와 직접 만든 Agent를 같은 30문항으로 비교하고, 이어서 LangGraph로 다시 만든 버전들이 결과를 바꾸는지 확인했다. 구현할 때 주의할 점과 평가 방법도 함께 정리했다.
실험에 쓴 회사 “누리테크”, 규정, 직원 정보는 모두 이 글을 위해 만든 가상 데이터이며 실제 업무 데이터는 쓰지 않았다.
먼저 결론 세 줄이다.
- 정확도는 Agent 80%(24/30), RAG-only 43%(13/30)였다. 차이는 도구가 필요한 질문(DB 조회, 날짜 계산)에서 났다.
- 규정 문서만 묻는 질문 10개는 RAG-only 9개, Agent 10개로 비슷했다. 규정, DB, 계산을 모두 이어야 하는 복합 질문 10개는 Agent도 4개만 맞혀 가장 약했다.
- 프레임워크(LangGraph), 안전망, 프롬프트 튜닝으로는 정확도가 거의 오르지 않았다. 채점 방식에 따라 숫자도 크게 달라져서 “평가를 평가하는” 장을 따로 넣었다.
1. LLM Agent란 무엇인가
LLM은 혼자서는 우리 회사의 사내 규정이나 직원 DB를 모른다. 학습한 적 없는 내용이기 때문이다. 그래서 “우리 회사 연차는 며칠이야?”라고 물으면 그럴듯하지만 근거 없는 답을 만들어 내기 쉽다. 이 문제를 풀려면 모델 바깥의 정보를 가져다줘야 한다.
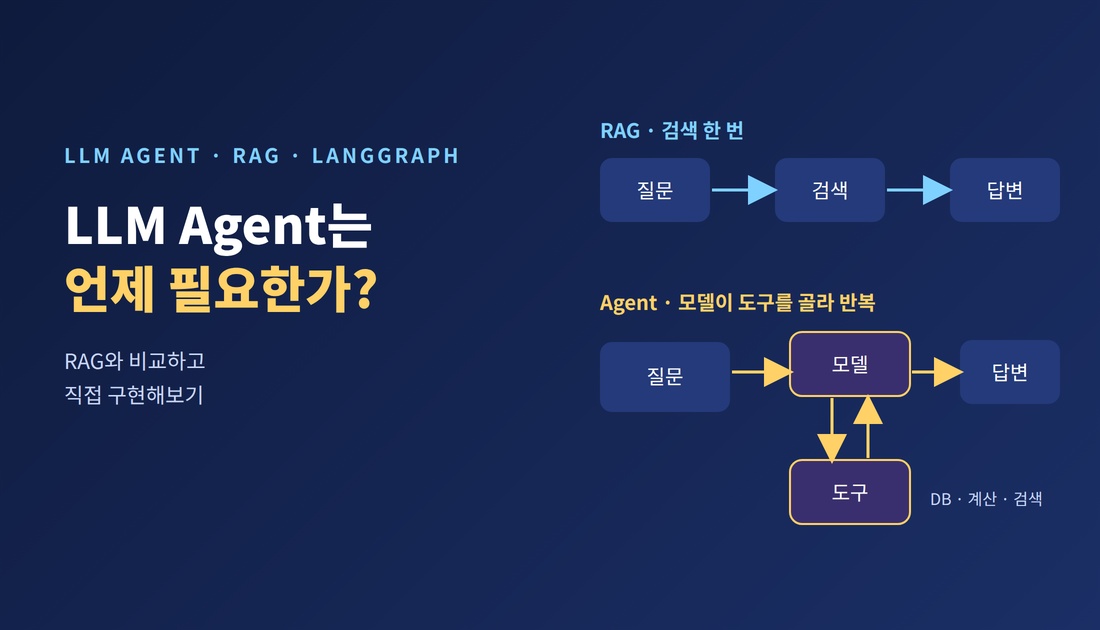
가장 먼저 쓰는 방법이 RAG다. 질문을 받으면 규정 문서에서 관련 조항을 항상 한 번 검색하고, 그 결과를 모델에 넣어 답하게 한다. 검색을 할지, 몇 번 할지를 코드가 미리 정해 두기 때문에 이런 구조를 워크플로우라고 부른다. 흐름이 고정되어 있어 예측하기 쉽고 비용도 적다.
Agent는 여기서 한 걸음 더 나간다. 검색, DB 조회, 계산을 각각 도구로 주고, 어떤 도구를 쓸지, 몇 번 쓸지, 어떤 순서로 쓸지를 모델이 정한다. 코드는 모델이 고른 도구를 실행해 결과를 돌려줄 뿐이다. 흐름을 코드가 정하면 워크플로우, 모델이 정하면 Agent라고 보면 된다.
Agent의 루프는 이렇게 돌아간다.
- 사용자 질문과 사용 가능한 도구 목록을 모델에 보낸다.
- 모델이 답 대신 tool_calls(어떤 도구를 어떤 인자로 쓸지)를 돌려준다.
- 코드가 그 도구를 실행하고 결과를 role: tool 메시지로 대화에 붙인다.
- 모델이 다시 호출된다. 도구가 더 필요하면 2번으로 돌아가고, 충분하면 최종 답변을 쓴다.
이 유연함에는 값이 따른다. 모델이 흐름을 정하니 검색이나 계산을 건너뛰고 답하는 일도 생길 수 있고, 호출이 늘어 비용과 응답 시간도 커진다. 그래서 이 글은 “Agent가 더 좋다”를 주장하지 않는다. “어떤 질문에서 Agent가 RAG보다 값을 하는가”를 같은 모델과 같은 질문으로 직접 재어 본다.
2. Agent가 필요한 때
Agent가 필요한지는 기술이 아니라 질문의 유형이 정한다. 이 실험에서는 질문을 세 유형으로 나눠 유형별 10개씩, 모두 30개를 만들었다. 그리고 유형별로 정확도를 따로 계산해 Agent가 어떤 질문에서 값을 하는지 나눠서 살펴봤다.
| 유형 | 답이 있는 곳 | 예시 |
|---|---|---|
| 문서 | 규정 문서만으로 답이 나온다 | “연속 3일 이상 연차는 언제까지 신청해야 해?” |
| 도구 | DB 조회나 날짜 계산이 필요하다 | 공휴일을 빼고 영업일이 며칠인지 세는 질문 |
| 복합 | 규정, DB, 계산을 모두 이어야 한다 | “10월 26일부터 30일까지 연차를 쓰려고 하는데, 며칠 차감되고 지금 신청해도 돼?” |
문서형은 검색 한 번이면 끝난다. 도구형은 문서에 답이 없다. 직원의 남은 연차는 DB에 있고, 날짜 차감은 공휴일 테이블을 봐야 정확하다. 복합형은 세 단계가 필요하다. 휴일을 포함해 며칠 차감되는지 계산하고, 잔여 연차를 조회하고, 연속 3일 이상이라는 규정에 따라 신청 기한과 승인 절차를 언급해야 한다.
3. 실험 설계
비교가 공정하려면 모델과 데이터를 고정하고 구현 방식만 바꿔야 한다. 가상 회사 “누리테크”의 사내 규정·HR 도우미를 만들고, 같은 모델(gpt-4o-mini)로 아래 환경에서 비교했다. 기준일은 2026-10-12(월)로 고정했다. “오늘”이 달라지면 신청 기한 같은 정답이 바뀌기 때문이다.
| 항목 | 내용 |
|---|---|
| 규정 문서 | 5개 파일(연차, 특별휴가, 재택근무, 출장비, 교육비)을 조항 단위 18개로 분할, bigram TF-IDF 검색 |
| HR DB | SQLite 3테이블(employees, leave_grants, leave_requests), 직원 4명 |
| Tool 5개 | search_policy, get_leave_balance, count_workdays, calculate, shift_date |
| 평가 질문 | 30개: 문서 10, 도구 10, 복합 10 |
| 추가 질문 | 처음 보는 질문 5개 |
먼저 비교할 구현 방식은 두 가지다.
- RAG-only: 질문으로 규정을 한 번 검색해 상위 3개 조항을 넣고 답한다.
근거가 없으면 “모른다”고 답하도록 지시했다. - 직접 만든 Agent: 모델이 Tool을 고르고 코드가 실행하는 while 루프(최대 6단계).
이 두 방식의 비교가 이 글의 중심이다(5장). 그 뒤에 같은 Agent를 LangGraph로 다시 만든 두 버전(create_agent, 직접 구성 + 안전망)을 더해 프레임워크가 결과를 바꾸는지 확인한다(7장).
채점은 문자열 일치, LLM Judge, 체크리스트 Judge를 같이 쓰고, 세 방식이 갈리는 문항은 생성형 AI가 답변을 읽고 판정했다(8장). 정확도뿐 아니라 토큰 수와 응답 시간도 같이 재었다.
4. 직접 구현: RAG에서 Agent로
프레임워크를 쓰기 전에 루프를 직접 만들었다. 프레임워크가 숨기는 것이 무엇인지 알아야, 나중에 그것이 정확도에 도움이 되는지 판단할 수 있기 때문이다.
루프의 핵심
모델이 tool_calls를 돌려주면 코드가 실행하고 결과를 role: tool 메시지로 붙인다. 이것이 전부다. 여기에 최대 단계 수(6)만 두어 무한 루프를 막았다. API는 이전 호출을 기억하지 않아서, 도구를 쓸 때마다 모델을 다시 부르고 지금까지의 메시지를 모두 다시 보낸다. 그래서 단계가 늘수록 입력 토큰이 쌓인다. 모델을 한 번만 부르는 RAG-only(평균 458토큰)와 Agent(1,425토큰)의 비용 차이의 한 원인이다.
직원 ID는 모델이 정하면 안 된다
연차 조회 Tool은 “누구의 연차인지”를 알아야 한다. 처음에는 이 정보를 Tool의 인자로 받게 만들었다. 모델이 직원 ID를 채워서 부르는 방식이다(naive).
문제는 모델이 질문 내용을 보고 ID를 고른다는 점이다. 예를 들어, 직원 E001이 다른 직원인 이서연의 연차를 묻자, 모델은 이서연의 ID를 넣어 Tool을 불렀고 그대로 다른 사람의 연차가 조회됐다. 사번을 적어 내면 누구든 남의 사번을 조회할 수 있는 것과 같다.
프롬프트에 “본인 것만 조회하라”고 적어 둘 수도 있지만, 그것은 모델에게 부탁하는 것이지 막는 것이 아니다. 누가 로그인했는지 확인하는 일은 모델이 아니라 서버의 몫이다.
그래서 secure 버전에서는 Tool에서 employee_id 인자를 아예 없앴다. 로그인한 직원의 ID는 서버가 따로 들고 있다가 Tool을 실행할 때 직접 넣는다. 모델은 ID를 정할 수도, 바꿀 수도 없다. 사원증을 찍고 들어가면 본인 자리만 열리는 것과 비슷하다. 이후 실험은 모두 secure Tool로 진행했다.
결과가 이상하면 도구부터 확인한다
날짜 계산 결과가 공휴일을 반영하지 못해 틀리게 나온 적이 있다. 모델의 문제로 보였지만 Tool 호출 기록을 찍어 보니 도구의 버그였다. 노트북에서 %run build_db.py를 실행하면 스크립트의 HOLIDAYS(튜플 리스트)가 노트북의 HOLIDAYS(dict)를 덮어쓴다. %run이 스크립트를 노트북과 같은 네임스페이스에서 실행하기 때문이다.
!python build_db.py로 바꾸자 해결됐다. Agent를 평가할 때는 답변뿐 아니라 Tool 호출 기록을 같이 봐야 한다.
5. 결과: RAG vs Agent
Agent는 RAG-only보다 정답이 11문항 많았고(24개/13개), 그 차이는 대부분 도구 질문에서 났다. 아래 숫자는 생성형 AI가 답변을 읽고 정한 검토 판정을 반영했다. 연속 3일 이상 연차 신청 질문은 기한과 팀장 승인을 함께 답해야 정답으로 봤는데, 이 기준은 판단이 갈릴 수 있어서 바꾸면 해당 4문항의 결과가 달라진다.
정확도는 두 가지 기준으로 셌다. 엄격은 정답만 인정한 비율이고, 관대는 부분 정답까지 포함한 비율이다.
| 구현 방식 | 정답(30문항) | 엄격 | 관대 | 문항당 토큰 | 응답 시간 |
|---|---|---|---|---|---|
| RAG-only | 13 | 43% | 77% | 458 | 1.38초 |
| 직접 만든 Agent | 24 | 80% | 90% | 1,425 | 3.50초 |
유형별로 보면 차이가 어디서 나는지 분명하다. 숫자는 유형당 10문항 중 맞힌 개수다.
| 유형 | RAG-only | 직접 만든 Agent |
|---|---|---|
| 문서 | 9 | 10 |
| 도구 | 2 | 10 |
| 복합 | 2 | 4 |
도구 질문에서 RAG-only는 10개 중 2개, Agent는 10개 전부를 맞혔다. 규정 문서에 답이 없으니 당연한 결과다. 문서 질문은 RAG-only도 9개를 맞혔고, 이 구간에서 Agent는 비용만 늘린다. 복합 질문은 Agent도 4개만 맞혀 가장 약했다(6장). 토큰은 Agent가 RAG-only의 약 3배다. 응답 시간도 Agent가 두 배 넘게 걸렸다. 다만 시간은 실행마다 흔들리는 값이라 큰 차이만 의미 있게 봤다.
틀릴 때의 모습도 다르다. RAG-only는 근거가 없으면 “모른다”고 답하고, Agent는 근거 없는 숫자를 답한다. RAG-only는 안전하게 실패하고 Agent는 자신 있게 실패한다. 사내 업무에서는 후자가 더 위험하다. 다만 RAG-only에는 “근거가 없으면 모른다고 답하라”는 지시를 넣었기 때문에 이렇게 동작하는 것이고, Agent에 같은 지시를 줬을 때의 차이는 확인하지 못했다.
6. 실패 패턴과 안전망
Agent가 틀린 문항을 고쳐 보니 다음 실패가 드러났고, 정확도는 24/30 근처에서 더 오르지 않았다.
실패 패턴
- 검색 없이 규정을 인용한다. search_policy(도구)를 부르지 않고 “규정 조항”을 적거나 틀린 규칙을 써서 지어낸 출처가 나왔다.
- 날짜 계산과 조건 추론이 약하다. shift_date에 인자를 지어내고, 근속 12년인데 “5의 배수”라며 대상자라고 답했다.
- 근거 없는 숫자를 말한다. 출장 숙박비 100,000원을 근거 없이 답했다.
- 고칠수록 다음 실패가 드러난다. 하나를 고치면 이번에는 검색 누락이 나타났다.
실패는 무작위로 나는 게 아니라 질문에 묶여 있다. 같은 질문을 3번 돌려도 같은 곳에서 틀렸다(9장).
Fallback: 안전망
fallback은 정상 경로가 실패했을 때 시스템이 망가지지 않도록 마련해 둔 대체 경로다. 이 실험에서 만든 안전망은 네 가지다.
- Tool이 오류를 내면 예외로 죽지 않고 오류 내용을 모델에 전달한다.
- API 호출이 실패하면 일시적 오류에 한해 재시도한다.
- 단계 수(max_steps)를 넘기면 루프를 멈추고 지금까지의 내용으로 최종 답변을 만든다(force_final).
- 같은 도구를 같은 인자로 계속 부르면 차단한다(반복 호출 가드).
이 네 가지는 정확도를 올리는 장치가 아니라 나쁜 실패를 줄이는 장치다. 끝없이 도는 루프와 비용 폭발, 예외로 인한 무응답을 막는다. 30문항을 돌리는 동안 fallback이 발동된 적은 한 번도 없었다. 안전망은 평상시에는 보이지 않는 보험이다. 다만 안전망의 메시지 문구도 동작을 바꾼다. 반복 호출 차단 메시지에 “포기하라”는 뉘앙스가 들어 있어 결과가 오히려 나빠진 경우가 있었다.
프롬프트와 Tool 결과 메모
정확도를 올리려고 두 가지를 시도했다. 시스템 프롬프트에 원칙을 더했고, Tool 결과에 “이미 휴일을 뺀 값이니 다시 빼지 마세요” 같은 주의 문구를 붙였다. 결과는 정답 수 24로 그대로였고 토큰만 1,425에서 1,955로 약 37% 늘었다. 모델이 문구를 무시하는 경우도 있었고, 특정 문항을 겨냥한 수정은 그 문항만 고쳤다. 다만 gpt-4o-mini와 이 30문항에서 한 번씩 돌린 결과이므로, 글로 하는 제약이 언제나 소용없다는 뜻은 아니다.
7. LangGraph로 다시 만들기
LangGraph는 같은 루프를 노드, 엣지, State로 쪼개어 만드는 도구다. 하는 일은 같지만 안전망을 끼워 넣기 쉽고, 그래프라서 흐름을 그림으로 볼 수 있다.
| 직접 만든 루프 | LangGraph |
|---|---|
| while 루프 | 노드와 조건 엣지 |
| messages 리스트 | State(MessagesState) |
| Tool 실행 코드 | ToolNode |
| 다음 단계 판단(tool_calls 있으면 계속) | tools_condition |
| max_steps | steps 카운터와 라우팅, recursion_limit |
recursion_limit은 그래프에서 노드가 실행되는 총 횟수의 상한이다. Agent 루프는 한 바퀴에 모델 노드와 Tool 노드를 한 번씩 실행하므로, 12로 두면 LLM을 약 6번 부르고 끝난다. ToolNode는 모델이 한 번에 요청한 Tool 여러 개를 한 단계에서 병렬로 실행하기도 한다.
LangGraph로 만든 버전은 두 가지다.
- create_agent: LangGraph가 제공하는 prebuilt 에이전트. 직접 구성 버전과 같은 구조(모델 노드, 도구 노드, 조건 엣지)를 몇 줄로 만들어 준다.
- LangGraph 직접 구성 + 안전망: 같은 루프를 StateGraph로 직접 짜고,
6장의 안전망 네 가지를 붙인 버전.
| 구현 방식 | 정답(30문항) | 엄격 | 관대 | 문항당 토큰 | 응답 시간 |
|---|---|---|---|---|---|
| 직접 만든 Agent (5장) | 24 | 80% | 90% | 1,425 | 3.50초 |
| LangGraph create_agent | 24 | 80% | 90% | 1,966 | 3.05초 |
| LangGraph 직접 구성 + 안전망 | 21 | 70% | 83% | 1,899 | 2.80초 |
직접 만든 루프와 create_agent는 모두 24/30으로 같았다. 프레임워크를 바꾸는 것이 정확도를 바꾸지는 않았다. 토큰은 create_agent가 더 많았지만(1,966) 이유는 따로 확인하지 않았다. 응답 시간은 실행마다 흔들려서 세 방식의 차이로는 읽지 않았다.
다만 직접 구성한 그래프에 안전망을 붙인 버전은 21/30이었다. fallback이 한 번도 발동하지 않았으니 안전망 때문이라고 하기도 어렵고, 이 차이의 원인은 설명하지 못했다.
8. 평가를 평가하기
채점 방식 하나만 믿으면 틀린 결론에 도달한다. 세 가지 자동 채점이 각자 다른 곳에서 틀렸고, 틀린 방향도 달랐다. 문자열 일치로는 Agent가 87%였는데, 답변을 읽고 정한 검토 판정으로는 80%였다.
| 방식 | 장점 | 대표 실패 사례 |
|---|---|---|
| 문자열 일치 | 비용 0, 즉시 계산 | 오탐: “10일”이 “11월 10일”에, “9일”이 “19일”에 우연히 일치. 미탐: “70만원”을 “700,000”과 다르다고 판정 |
| 한 번에 채점하는 LLM Judge | 표현이 달라도 의미를 보고, 통째로 읽음 | 핵심 조건(팀장 승인)이 빠져도 정답 처리, 맞는 답을 부분 정답으로 낮추고, 이유를 지어냄 |
| 체크리스트 Judge | 정답을 사실 단위로 쪼개고, 사실마다 근거 문장을 인용하게 하고, 코드가 인용을 검증 | 부연까지 필수로 쪼개서 박하게 판정, 의미 동치를 못 알아봄(“내년 6월 30일” vs “2027년 6월 30일”, “70만원” vs “700,000원”) |
한 번에 채점하는 Judge는 답변 전체를 읽고 의미로 판단하고, 체크리스트 Judge는 정답을 사실 단위로 쪼개 하나씩 판단한다. 쪼개면 빠뜨린 조건은 잘 잡지만, 정답을 너무 잘게 나누면 부가 설명까지 필수로 취급한다. 두 Judge 모두 “결론은 맞지만 근거가 틀린 답”을 잡지 못했다.
다섯 번의 실행(150개 답변)에서 세 가지 채점 방식(문자열 일치, LLM Judge, 체크리스트 Judge)의 판정이 갈린 답변은 처음 49개였고, 채점 기준을 고쳐 다시 채점하면서 35개, 19개로 줄었다. 기준은 결과를 본 뒤에 일부 수정했고(체크리스트 재생성, 정답지 보정, 근거 인용 검사 완화), 남은 불일치는 생성형 AI가 답변을 읽고 정답, 부분 정답, 오답으로 판정했다.
9. 재현성과 일반화, 자가 교정
Agent의 실패는 우연이 아니라 질문에 묶여 있었고, 처음 보는 질문에서도 비슷했다.
3회 반복. 직접 만든 Agent를 같은 30문항에 3번 돌렸다. 30문항 중 29개가 3회 모두 같은 판정이었고 흔들린 문항은 하나뿐이었다. 틀린 질문은 다시 돌려도 틀렸으므로 다수결이나 반복으로는 고칠 수 없는 구조적 오류다.
처음 보는 질문 5개. 정답과 필수 사실을 실행 전에 확정하고 돌렸다. Agent는 4/5, RAG-only는 3/5였다. Agent 80%로 기존 30문항과 같아 과적합 징후는 없었지만 5문항이라 오차가 크다.
자가 교정. Agent가 답한 뒤 같은 모델이 “이 답이 정말 맞는가”를 검토하고, 문제가 있으면 피드백을 붙여 한 번 더 답하게 했다. 30문항 중 4개를 지적했고, 그중 근거 없는 숙박비 답변은 정확히 잡아 정답으로 고쳤다. 한 건은 틀린 이유로 지적했지만 수정 결과가 나아졌고, 두 건은 오탐이었다. 추론 오류나 검색을 빠뜨리고 지어낸 출처는 같은 모델이라 못 잡았다. 자가 교정은 검토자가 알아보는 유형의 결함만 잡는다.
10. 정리
Agent는 답이 문서 밖에 있을 때 쓴다. 문서만 묻는 질문은 RAG로 충분하고, DB 조회나 계산이 필요할 때 Agent가 확실히 이긴다. 다만 규정과 DB와 계산을 모두 이어야 하는 복합 질문에서는 Agent도 약했다.
네 방식 한눈에 보기
| 구현 방식 | 정답(30문항) | 엄격 | 관대 | 문항당 토큰 | 응답 시간 |
|---|---|---|---|---|---|
| RAG-only | 13 | 43% | 77% | 458 | 1.38초 |
| 직접 만든 Agent | 24 | 80% | 90% | 1,425 | 3.50초 |
| LangGraph create_agent | 24 | 80% | 90% | 1,966 | 3.05초 |
| LangGraph 직접 구성 + 안전망 | 21 | 70% | 83% | 1,899 | 2.80초 |
RAG-only와 Agent 사이에서는 정확도가 크게 갈렸고, Agent 세 버전 사이에서는 프레임워크나 안전망으로 정확도가 오르지 않았다.
Agent 도입 체크리스트
- 질문의 답이 문서 밖(DB, 날짜 계산, 외부 시스템)에 있는가? 문서에 있으면 RAG부터 시작한다.
- 토큰 3배 정도의 비용과 더 긴 응답 시간을 감당할 수 있는가?
- 틀렸을 때 자신 있게 틀리는 것을 감당할 수 있는가? 사내 업무라면 출처와 Tool 호출 기록을 함께 보여 주고, 복합 질문은 사람이 확인하는 경로를 둔다.
- 직원 ID 같은 권한 정보는 서버가 고정하는가? 모델이 고르는 파라미터가 있으면 유출 위험이 있다.
한계
이 실험은 작은 모델 하나(gpt-4o-mini), 가상 회사의 30문항이다. 판정은 생성형 AI가 했고 사람이 다시 확인하지 않았다. 더 강한 모델에서는 결과가 달라질 수 있다. 그래서 숫자를 그대로 일반화하기보다, 질문 유형에 따라 달라지는 패턴을 읽어 내는 것이 이 글의 의미다.