1. 들어가며
인터넷이 없는 분석실에서 약 19.8억 행을 하나로 붙여야 했습니다.
건강보험공단 청구자료로 4개 시·군 거주자 약 161만 명의 10년간(2015~2024년) 의료 이용 현황을 분석하는 과제였습니다. 분석은 외부와 차단된 원격 가상 분석실에서만 할 수 있었습니다. 새 도구를 설치하거나 외부 데이터를 들여올 수 없었기 때문에, 이미 갖춰진 Python 환경 안에서 방법을 찾아야 했습니다.
원본 테이블은 통계 분석 소프트웨어인 SAS(Statistical Analysis System)의 데이터 파일 (.sas7bdat)이었고, 파일은 연도별·월별로 나뉘어 있었습니다. 청구명세서와 진료내역, 상병내역만 해도 종류별 월 파일이 120개씩, 모두 360개였습니다. 분석 대상자 기준으로 걸러 적재한 결과는 다음과 같습니다.
| 테이블 | 상세 내용 | 적재 후 행 수 |
| 진료내역 | 명세서별 진료행위 | 908,610,968 |
| 상병내역 | 명세서별 상병 | 763,116,932 |
| 청구명세서 | 청구 1건이 1행 | 296,855,830 |
| 건강보험 자격자 | 대상자의 연도별 개인정보 | 10,760,731 |
| 요양기관 | 요양기관 상세 정보 | 1,003,847 |
| 사망 | 사망환자의 사망일자 | 73,007 |
[표 1] 분석 대상자 기준으로 걸러 적재한 테이블별 행 수
이 데이터를 모두 담은 데이터베이스(DB, Database) 파일은 198.79GB였습니다. 이 글은 이 규모의 데이터를 SQLite 하나로 적재·결합·정제한 방법을, 바로 가져다 쓸 수 있는 코드와 함께 정리합니다. 테이블·컬럼·경로 이름은 보안을 위해 일반화했습니다.
2. 왜 SQLite 인가
설치가 막힌 환경에서 가장 확실한 선택지는 이미 내부에 들어 있는 도구입니다.
SQLite는 Python 표준 라이브러리(sqlite3 모듈)에 들어있습니다. 별도 서버를 띄우거나 패키지를 설치하지 않아도 파일 하나로 데이터베이스를 쓸 수 있습니다. 메모리에 다 올릴 수 없는 데이터를 디스크에 두고, SQL로 거르고 묶을 수 있다는 점이 핵심입니다.
다만 폐쇄망 분석 환경은 버전이 오래된 경우가 많습니다. 이번 분석실의 Python 3.8에 SQLite 3.25.0 미만 버전이었습니다. SQLite는 3.25.0 부터 윈도 함수(Window Function)를 지원하므로[1], 그보다 낮은 버전에서 ROW_NUMBER() OVER (…)를 쓰면 near “(“: syntax error가 납니다.
쿼리를 짜기 전에 버전부터 확인해 두면 시행착오를 줄일 수 있습니다.
| import sqlite3 print(sqlite3.sqlite_version) # 3.25.0 미만이면 ROW_NUMBER, RANK 등 윈도 함수 사용 불가 |
윈도 함수 없이 “그룹별 최신 1건”을 고르는 방법은 8장에서 소개합니다.
3. 전체 흐름 : 원본은 파일에, 결과만 데이터베이스에
전체 구조는 단순합니다. 원본은 SAS 파일 그대로 두고, 분석에 필요한 행과 열만 걸러 SQLite에 쌓았습니다.
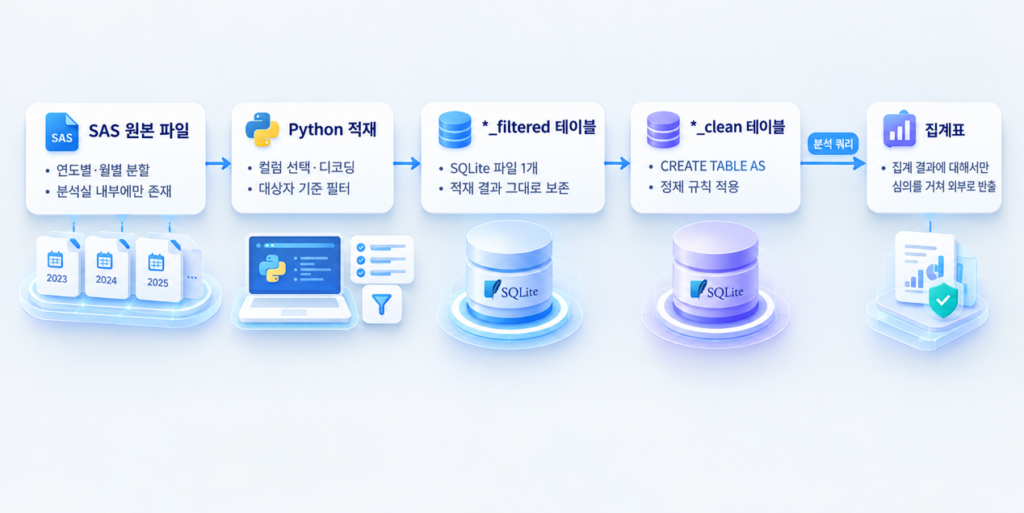
[그림 1] 원본 파일에서 집계표 산출까지의 적재·정제 파이프라인
이 구조는 세가지 원칙에서 나왔습니다.
- 원본은 건드리지 않음 : 원본은 SAS 파일로 남겨 두고, 분석에 필요한 행과 열만 데이터베이스로 옮깁니다. 문제가 생기면 언제든 원본에서 다시 만들 수 있습니다.
- 파일 하나 당 작업 하나 : 월별 파일 하나를 처리 단위로 삼습니다. 하나가 실패하면 그 파일만 다시 돌리면 됩니다.
- 적재 테이블과 정제 테이블 분리 : 적재 테이블(*_filtered)은 그대로 보존하고, 정제 규칙은 CREATE TABLE AS로 만든 별도 테이블(*_clean)에 적용합니다.
세 번째 원칙이 특히 유용했습니다. 정제 규칙을 바꿀 때마다 수억 행짜리 원본을 다시 읽지 않아도 됐기 때문입니다. 적재는 한 번, 정제는 여러 번 할 수 있는 구조입니다.
4. 적재 : 파일 하나씩, 필요한 것만
메모리 부족을 막은 원칙은 “메모리에는 한 번에 파일 하나만”이었습니다.
pandas의 read_sas는 파일 하나를 통째로 읽습니다. 따라서 전체 데이터가 몇억 행이든, 최대 메모리 사용량은 가장 큰 월 파일 하나가 정합니다. 그래서 연월 단위로 읽고, 거르고, 적재하고, 바로 비우는 순서로 반복했습니다.
데이터 양을 줄인 방법은 네 가지입니다.
- 필요한 컬럼만 남기기 : 명세서는 28개 중 18개, 요양기관은 28개 중 21개, 건강보험 자격자 정보는 12개 중 6개만 분석에 활용할 변수로 선정했습니다.
- 부모 키로 자식 거르기 : 자격자 정보 테이블에서 대상 시·군 거주자의 개인 식별번호(ID, Identifier)를 추출했습니다. 그 ID로 명세서를 거르고, 그 달 명세서 키로 다시 진료내역과 상병내역을 걸렀습니다.
- 바로 비우기 : 적재가 끝난 데이터프레임은 del과 gc.collect()로 즉시 해제합니다.
- 멈춘 곳부터 다시 시작하기 : 테이블에 해당 연월의 행이 이미 있으면 건너뛰도록 했습니다. 세션이 끊겨도 처음부터 다시 돌릴 필요가 없게끔 조치한 것입니다.
아래는 명세서와 진료내역 적재의 요지만 남긴 코드입니다.
| import gc import sqlite3 import pandas as pd def decode_df(df): # read_sas는 문자열을 bytes로 읽으므로 먼저 디코딩한다 for col in df.select_dtypes(include=’object’).columns: df[col] = df[col].str.decode(‘utf-8′, errors=’replace’) return df def is_done(table, ym): # 이미 적재된 연월이면 True → 건너뛴다 try: q = f”SELECT COUNT(*) FROM {table} WHERE ym = ‘{ym}'” return conn.execute(q).fetchone()[0] > 0 except sqlite3.OperationalError: # 테이블이 아직 없음 return False persons = pd.read_sql(“SELECT DISTINCT person_id, year FROM qual_filtered”, conn) for year in range(2015, 2025): ids = set(persons.loc[persons[‘year’] == year, ‘person_id’]) for month in range(1, 13): ym = f”{year}{month:02d}” # 1) 명세서: 대상자 ID로 거른다 if not is_done(‘claim_filtered’, ym): df = decode_df(read_sas_safe(src_dir / f”claim_{ym}.sas7bdat”)) df = df[CLAIM_COLS] df = df[df[‘person_id’].isin(ids)] df.assign(year=year, ym=ym).to_sql(‘claim_filtered’, conn, if_exists=’append’, index=False) conn.commit() del df; gc.collect() # 2) 진료내역: 방금 적재한 그 달 명세서 키로 거른다 if not is_done(‘detail_filtered’, ym): keys = set(pd.read_sql( f”SELECT DISTINCT claim_key FROM claim_filtered WHERE ym = ‘{ym}'”, conn)[‘claim_key’]) df = decode_df(read_sas_safe(src_dir / f”detail_{ym}.sas7bdat”)) df = df[DETAIL_COLS] df = df[df[‘claim_key’].isin(keys)] df.assign(year=year, ym=ym).to_sql(‘detail_filtered’, conn, if_exists=’append’, index=False) conn.commit() del df; gc.collect() |
두 번째 방법(부모 키로 자식 거르기) 덕분에 대상자와 무관한 진료행위는 처음부터 데이터베이스에 들어오지 않았습니다. [표 1]의 진료내역 약 9.1억 행도 이렇게 거르고 남은 양입니다.
알아 두면 좋은 점
- 파일이 더 크다면 : 위 방식은 파일을 다 읽은 뒤 거릅니다. 월 파일 하나도 메모리에 들어가지 • 않는다면 pd.read_sas(path, chunksize=…)로 나눠 읽고, 묶음마다 거르고 적재하는 방식으로 바꾸면 됩니다.
- 완료 판정을 더 단단하게 : “그 달에 적재된 행이 있는가”에 대한 확인은 간단하지만, 적재 도중 끊긴 달도 완료로 보일 수 있습니다. 완료한 연월을 별도 테이블에 기록해 두면 더 안전합니다.
5. 손상된 원본 파일 다루기 : 단계별 폴백
대용량 SAS 파일 중에는 한 번에 읽히지 않는 파일이 섞여 있을 수 있습니다.
이럴 때는 읽기 방식을 한 단계씩 바꿔 가며 시도하는 함수를 두면 편합니다. 흐름은 세 단계입니다.
- 일반 읽기(pd.read_sas)를 시도합니다.
- 실패하면 반복자(Iterator)로 묶음 단위로 읽고, 오류가 난 묶음만 건너뜁니다. 묶음 크기는 10,000 → 5,000 → 1,000 → 500 → 100행으로 줄여 가며, 건너뛰는 범위를 최소화합니다.
- 그래도 안 되면 문자 인코딩을 latin1, cp949, euc-kr 순서로 바꿔 봅니다.
| MAX_SKIP = 50 # 같은 위치에서 계속 실패할 때 무한 반복을 막는 상한 def read_sas_safe(path, chunk_sizes=(10000, 5000, 1000, 500, 100)): # 1) 한 번에 읽기 try: return pd.read_sas(path) except Exception as e: print(f”일반 읽기 실패: {e}”) # 2) 묶음 크기를 줄여 가며, 오류 난 묶음만 건너뛰기 for cs in chunk_sizes: chunks, skipped = [], 0 try: reader = pd.read_sas(path, chunksize=cs, iterator=True) while True: try: chunk = reader.read() if chunk is None or len(chunk) == 0: break chunks.append(chunk) except StopIteration: break except Exception: skipped += 1 if skipped >= MAX_SKIP: break reader.close() except Exception as e: print(f”chunksize={cs} 실패: {e}”) continue if chunks: print(f”chunksize={cs}: {sum(map(len, chunks)):,}행, 건너뛴 묶음 {skipped}개”) return pd.concat(chunks, ignore_index=True) # 3) 인코딩을 바꿔 읽기 (이 경우 문자열이 이미 디코딩되어 반환됨) for enc in (‘latin1’, ‘cp949’, ‘euc-kr’): try: return pd.read_sas(path, encoding=enc) except Exception: continue return None |
알아 두면 좋은 점
- 묶음 단위 읽기(청크, Chunk)의 역할 : 여기서 묶음은 메모리를 아끼는 장치가 아니라 손상된 레코드를 격리하는 장치입니다. 읽어 낸 묶음은 결국 pd.concat으로 합쳐지므로 메모리 사용량은 일반 읽기와 비슷합니다.
- 건너뛴 묶음은 기록으로 남기기 : 건너뛴 묶음의 행은 분석에서 빠집니다. 파일명·묶음 크기·건너뛴 개수를 로그 테이블에 남겨 두면, 나중에 원본 행 수와 대조해 유실 여부를 확인할 수 있습니다.
- 인코딩 단계와 디코딩 함수: encoding을 지정해 읽으면 문자열이 이미 str로 반환됩니다. 이때는 4장의 decode_df를 다시 적용하지 않도록 분기해 두어야 합니다.
6. 작업에 맞게 설정 나누기
같은 데이터베이스라도 작업마다 맞는 설정이 다릅니다.
SQLite는 PRAGMA 문으로 캐시 크기나 디스크 동기화 방식 같은 동작을 바꿀 수 있습니다. 이번 작업에서는 설정을 두 벌로 나눠 썼습니다. 적재·조회 때는 메모리를 넉넉히 쓰고, 큰 색인(인덱스, Index)을 만들 때는 메모리를 아끼는 쪽으로 바꿉니다.
| 설정 | 적재·조회 단계 | 색인 생성 단계 | 뜻 |
| journal_mode | WAL | (그대로 유지) | 쓰는 중에도 읽기 허용 |
| synchronous | NORMAL | OFF | 디스크 기록 완료를 얼마나 기다릴지 |
| cache_size | -524288 (512MB) | -131072 (128MB) | 페이지 캐시 크기(음수는 KiB 단위) |
| temp_store | MEMORY | FILE | 정렬·임시 데이터를 메모리와 파일 중 어디에 둘지 |
| mmap_size | (기본값) | 0 | 메모리 맵 입출력 사용 여부 |
[표 2] 작업 단계별 SQLite 설정 비교
| # 적재·조회용: 메모리를 넉넉히 conn = sqlite3.connect(db_path) conn.execute(“PRAGMA journal_mode = WAL”) conn.execute(“PRAGMA synchronous = NORMAL”) conn.execute(“PRAGMA cache_size = -524288”) # 512MB conn.execute(“PRAGMA temp_store = MEMORY”) # 대형 색인 생성용: 정렬 임시 데이터는 디스크로 conn.execute(“PRAGMA cache_size = -131072”) # 128MB conn.execute(“PRAGMA temp_store = FILE”) conn.execute(“PRAGMA mmap_size = 0”) conn.execute(“PRAGMA synchronous = OFF”) # 재생성 가능한 분석용 DB에서만 |
WAL은 선행 기록 로그(WAL, Write-Ahead Logging) 방식입니다. 변경 내용을 별도 로그 파일에 먼저 쓰기 때문에, 쓰는 도중에도 다른 연결이 읽을 수 있습니다.
색인을 만들 때 설정을 바꾸는 이유는 정렬입니다. 색인 생성은 키 값을 정렬하는 작업이라 임시 데이터가 많이 생깁니다. 진료내역처럼 9억 행이 넘는 테이블에서 이 임시 데이터를 메모리에 두면 메모리가 부족할 위험이 큽니다. 캐시를 줄이고 임시 데이터를 디스크로 돌리면 이 위험을 피할 수 있습니다.
알아 두면 좋은 점
- synchronous = OFF는 사본에서만 : SQLite 공식 문서에 따르면 이 설정은 일부 작업을 크게 빠르게 하지만, 디스크에 기록되기 전에 운영체제가 멈추거나 전원이 끊기면 데이터베이스가 손상될 수 있습니다[2]. 원본 파일에서 언제든 다시 만들 수 있는 분석용 사본에서만 쓰는 것이 안전합니다.
- 효과는 환경마다 다릅니다 : 적절한 값은 메모리·디스크 사양에 따라 달라집니다. 적용 전후로 같은 쿼리의 실행 시간을 재 보고 값을 정하는 것을 권합니다.
7. 색인 설계 : 붙이는 키와 거르는 키
색인은 모든 적재가 끝난 뒤 한꺼번에 만듭니다.
적재 중에 색인이 있으면 행을 넣을 때마다 색인도 함께 고쳐야 하기 때문입니다. 색인을 거는 기준은 두 가지입니다. 테이블끼리 붙일 때 쓰는 조인 키, 그리고 조건절에서 자주 거르는 필터 키입니다.
| 테이블 | 색인 컬럼 | 용도 |
| 명세서 | 명세서키 · 개인 ID ·연도 · (개인 ID, 연도) · 기관 ID | 진료내역·상병내역·자격자 정보·요양기관과 조인, 연도 필터 |
| 진료내역 | 명세서키 · (명세서키, 분류코드) · 분류코드 · 연도 | 명세서와 조인, 특정 진료행위 필터 |
| 상병내역 | 명세서키 | 명세서와 조인 |
| 자격자 정보 | 개인 ID · 연도 · (개인 ID, 연도) | 명세서와 연도별 조인 |
| 요양기관 | 기관 ID · 연도 | 명세서와 조인 |
| 사망 | 개인 ID · (사망연도, 개인 ID) | 자격자 정보와 조인, 연도별 사망 집계 |
[표 3] 테이블별 색인 구성. 괄호는 여러 컬럼을 묵은 복합 색인
1장의 198.79GB는 색인을 만든 뒤 측정한 값이라 색인 크기가 포함되어 있습니다. 색인도 디스크를 차지하므로 필요한 것만 두는 것이 좋습니다.
색인 설계 팁
- 복합 색인의 첫 컬럼은 단일 색인을 대신합니다 : (명세서키, 분류코드) 색인은 명세서키만으로 찾는 조회에도 쓰일 수 있습니다. 두 색인을 모두 만들기 전에 하나로 충분한지 확인해야 합니다.
- 값 종류가 적은 컬럼은 단독보다 복합으로 : 연도처럼 값이 10개뿐인 컬럼은 단독 색인의 효과가 작을 수 있습니다. (개인 ID, 연도)처럼 자주 함께 거르는 컬럼과 묶는 편이 낫습니다.
- 색인이 실제로 쓰이는지 확인하기 : EXPLAIN QUERY PLAN을 앞에 붙이면 쿼리가 어느 색인을 타는지 볼 수 있습니다.
- 색인 효과를 비교하기 : 테이블 이름 뒤에 NOT INDEXED를 붙이면 그 테이블을 읽을 때 어떤 색인도 쓰지 않습니다[3]. 색인을 지우지 않고도 있을 때와 없을 때를 비교할 수 있습니다. 다만 공식 문서는 이 구문을 성능 조정용이 아니라 실행 계획 변화 감지용으로 설명하므로, 비교 측정에만 쓰는 편이 맞습니다.
| — 색인 사용 여부 확인 EXPLAIN QUERY PLAN SELECT COUNT(*) FROM claim_clean WHERE person_id = ? AND year = 2024; — 같은 조건을 색인 없이 실행해 시간 비교 (범위는 한 연도로 좁혀서) SELECT COUNT(*) FROM claim_clean NOT INDEXED WHERE year = 2024; |
8. 결합 전에 확인할 것 : 오류 없이 틀리는 조인
대용량 결합에서 더 위험한 것은 느린 쿼리가 아니라 틀린 결과입니다.
조인은 오류 메시지 없이 끝나도 행을 중복시키거나 빠뜨릴 수 있습니다. 그래서 본 분석에 앞서 아래 네 가지를 구조화 질의 언어(SQL, Structured Query Language)로 먼저 점검했습니다.
| 점검 항목 | 방법 | 막으려는 문제 |
| 참조 무결성 | 명세서의 기관 ID 중 요양기관 테이블에 없는 것을 LEFT JOIN … IS NULL로 조회 | 조인 뒤 기관 정보가 비는 행 |
| 코드값 일치 | 같은 기관의 명세서 종별이 요양기관 종별 이력에 없는 경우 조회 | 두 테이블 중 어느 쪽 종별을 믿을지 모르는 상태 |
| 누적 방식 | 기관별 첫·마지막 등장 시점과 등장 횟수의 분포 확인 | 기관 1곳이 여러 행으로 붙는 행 중복 증폭 |
| 시계열 급변 | 2019 → 2020년 명세서 급감을 월별 추이, 1인당 건수, 원본 월별 행 수로 교차 확인 | 코로나 19 영향과 추출 누락의 혼동 |
[표 4] 결합 전 점검 항목
1) 행 중복 증폭(팬아웃, Fan-out) 잡기
요양기관 테이블은 기관별로 해마다 한 번씩 기록이 쌓이는 구조였습니다. 기관 1곳이 연도 수만큼 여러 행을 가진다는 뜻입니다.
이 테이블을 명세서에 기관 ID로 그대로 붙이면 명세서 1건이 그 기관의 행 수만큼 복제됩니다. 쿼리는 정상적으로 끝나지만 집계값은 부풀려집니다. 이렇게 한쪽 테이블의 중복 때문에 결과 행이 불어나는 현상을 행 중복 증폭(팬아웃)이라고 합니다.
가장 간단한 확인법은 조인 전후 행 수를 비교하는 것입니다. 빠지는 행까지 포함해 보려면 LEFT JOIN으로 세야 합니다.
| SELECT COUNT(*) FROM claim_clean; — 조인 전 SELECT COUNT(*) FROM claim_clean c LEFT JOIN inst_clean i USING (inst_id); — 조인 후 — 두 값이 다르면 오른쪽 테이블에 키가 중복된 것 |
해결책은 조인 전에 기관별 대표 1건만 남긴 테이블을 만드는 것입니다. 보통은 ROW_NUMBER를 쓰지만, 윈도 함수가 없는 환경에서는 SQLite의 베어 컬럼(Bare Column) 규칙을 쓸 수 있습니다. 집계 함수가 MAX() 하나뿐인 GROUP BY 쿼리에서는, 집계하지 않은 컬럼의 값이 최댓값을 가진 행에서 나옵니다[4].
| — 기관별 최신 기준월 1건 (윈도 함수 없이) CREATE TABLE inst_rep AS SELECT inst_id, region_cd, — MAX(std_ym)이 있는 행의 값이 선택됨 MAX(std_ym) AS std_ym FROM inst_clean GROUP BY inst_id; — 기관당 1행 보장: 중복이 있으면 여기서 오류가 난다 CREATE UNIQUE INDEX idx_inst_rep ON inst_rep(inst_id); |
한 가지 주의할 점이 있습니다. 같은 기관에 최신 기준월 행이 둘 이상이면, 그중 어느 행의 값이 뽑힐지는 정해져 있지 않습니다[4]. 아래 쿼리로 그런 기관이 있는지 먼저 확인해 두면 안심하고 쓸 수 있습니다.
| — 최신 기준월에 값이 서로 다른 행이 있는 기관 (0건이면 안전) SELECT i.inst_id FROM inst_clean i JOIN inst_rep r ON i.inst_id = r.inst_id AND i.std_ym = r.std_ym GROUP BY i.inst_id HAVING COUNT(DISTINCT i.region_cd) > 1; |
2) 정제 테이블
점검 결과를 바탕으로 정제 규칙을 CREATE TABLE AS로 적용했습니다.
- 불완전한 주소코드 제외 : 실거주 주소코드가 5자리뿐인 434행(25명)을 제외했습니다. 이 코드로는 읍·면·동을 알 수 없기 때문입니다.
- 약국 제외 : 약국은 의료기관 이용 분석의 대상이 아니므로 제외했습니다. 명세서는 296,855,830행에서 191,911,150행으로 약 35% 줄었고, 요양기관 테이블은 1,003,847행에서 756,712행이 됐습니다.
- 행정구역 코드 통합 : 분석 기간 중 코드가 바뀐 읍·면·동은 하나의 코드로 묶은 뒤 집계했습니다.
정제 전 후의 행 수와 인원 수를 한 쿼리로 나란히 출력해 두면, 규칙 하나가 데이터를 얼마나 바꿨는지 바로 보입니다.
| SELECT ‘적재 테이블’ AS 구분, COUNT(*) AS 행수, COUNT(DISTINCT person_id) AS 인원수 FROM qual_filtered UNION ALL SELECT ‘정제 테이블’, COUNT(*), COUNT(DISTINCT person_id) FROM qual_clean; |
9. 정리 : 폐쇄망 대용량 결합 체크리스트
폐쇄망에서도 표준 라이브러리만으로 수십억 행을 다룰 수 있습니다. 핵심은 도구보다 작업 순서입니다. 비슷한 환경에서 바로 적용할 수 있도록 앞의 내용을 체크리스트로 정리합니다.
| 단계 | 할 일 | 해당 장 |
| 준비 | sqlite3.sqlite_version으로 윈도 함수 지원 여부 확인 | 2장 |
| 적재 | 파일 하나씩 읽고, 필요한 컬럼만 남기고, 완료 지점 기록 | 4장 |
| 적재 | 부모 테이블의 키로 자식 테이블을 먼저 거르기 | 4장 |
| 적재 | 손상 파일은 단계별로 읽고, 건너뛴 묶음은 기록 | 5장 |
| 설정 | 적재용과 색인 생성용 PRAGMA를 나눠 적용 | 6장 |
| 색인 | 적재가 끝난 뒤, 조인 키·필터 키에만 만들고 실행 계획으로 확인 | 7장 |
| 결합 | 조인 전후 행 수를 비교해 행 중복 증폭 확인 | 8장 |
| 정제 | 적재 테이블은 보존하고, 정제는 별도 테이블에 | 3·8장 |
[표 5] 폐쇄망 대용량 결합 체크리스트
분석 환경에 분석용 엔진을 들일 수 있다면 선택지는 더 넓어집니다. 그러나 어떤 도구를 쓰든 파일 단위로 나누어 처리하고, 붙이기 전에 키가 몇 번 붙는지 확인하는 것은 좋은 습관입니다.
참고 자료
• [1] SQLite, Window Functions — https://www.sqlite.org/windowfunctions.html
• [2] SQLite, PRAGMA Statements (synchronous) — https://www.sqlite.org/pragma.html#pragma_synchronous
• [3] SQLite, The INDEXED BY Clause — https://sqlite.org/lang_indexedby.html
• [4] SQLite, SELECT (2.5. Bare columns in an aggregate query) — https://www.sqlite.org/lang_select.html