1. 들어가며
같은 모델을 쓰는데 결과가 다릅니다.
대규모 언어 모델(LLM, Large Language Model) 에이전트를 만들어본 조직이라면 한 번쯤 겪는 상황입니다. 데모에서는 잘 돌던 에이전트가 실제 업무에 붙이면 엉뚱한 도구를 호출하고 몇 턴이 지나면 처음 지시를 잊고 스무 단계짜리 작업의 열두 번째 단계에서 조용히 어긋납니다. 모델을 더 좋은 것으로 바꿔보지만 실패 양상만 바뀔 뿐 사라지지는 않습니다.
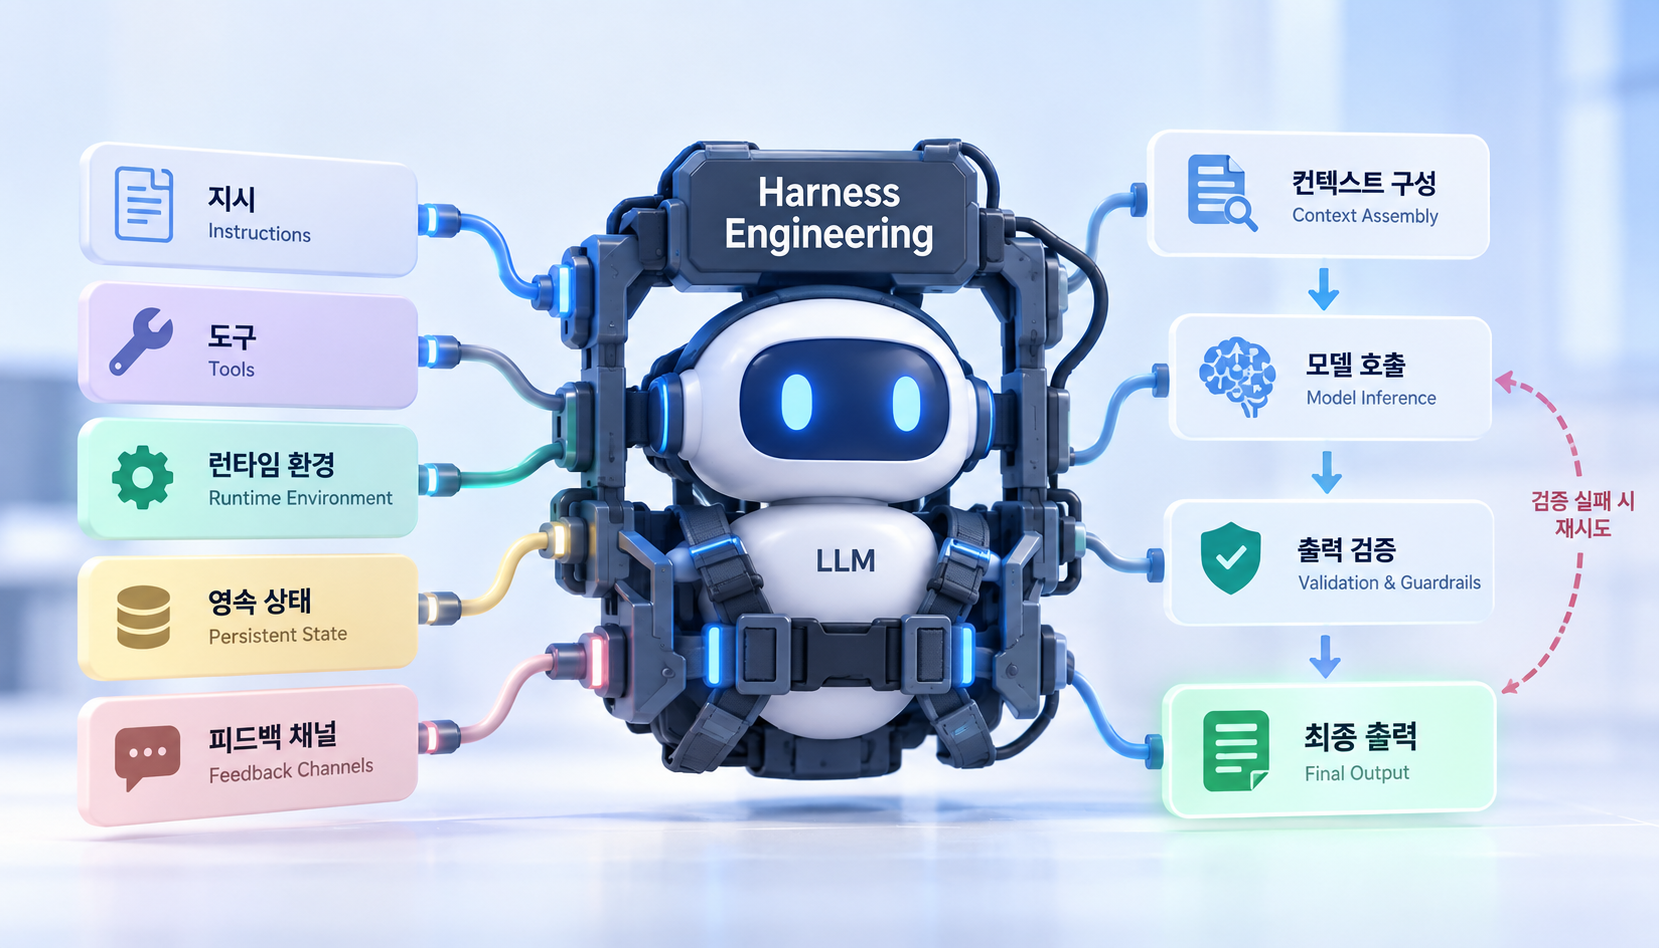
이 문제를 모델의 한계가 아니라 모델을 둘러싼 구조의 문제로 보자는 관점이 최근 1~2년 사이에 자리를 잡았습니다. 이것이 하네스 엔지니어링(harness engineering)입니다.
2. 하네스라는 말은 어디서 왔나
낯선 용어처럼 보이지만 소프트웨어 공학에는 이미 있던 개념입니다. 테스트 하네스는 상위 코드가 아직 없는 상태에서 하위 코드를 실행해보기 위해 두르는 골격 코드를 뜻합니다. 대상 자체를 바꾸지 않으면서 대상이 동작할 조건과 검증 지점을 바깥에서 마련해주는 장치입니다.
LLM 에이전트에서의 하네스도 발상이 같습니다. 모델은 고정된 채로 두고 그 바깥을 코드로 설계합니다. 최근 연구들은 하네스를 에이전트가 복잡한 환경에서 안정적으로 일할 수 있게 해주는 외부 구조로 정의하면서 이것이 프롬프트 이상임을 강조합니다. 지시, 도구, 런타임 환경, 영속 상태, 피드백 채널까지가 하네스의 범위입니다.
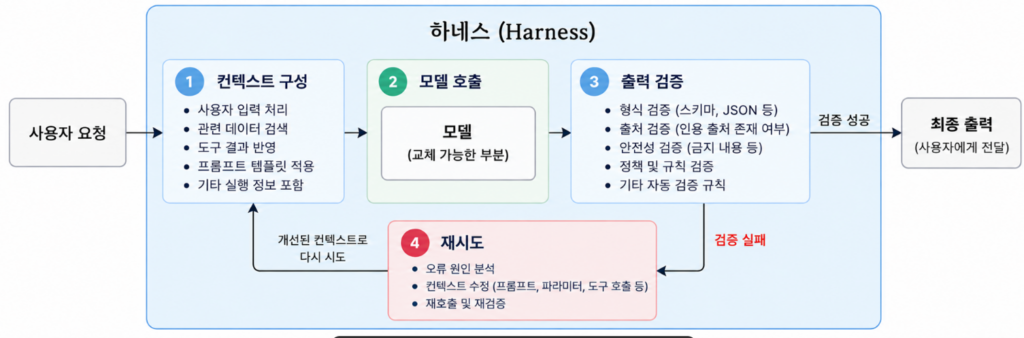
핵심 주장은 이렇게 요약됩니다. 하네스는 모델을 더 똑똑하게 만들지 않습니다. 대신 모델을 닫힌 루프 안에서 동작하는 작업 시스템의 한 부품으로 바꿉니다. 에이전트의 성능은 모델의 능력만이 아니라 주변 시스템이 그 과제를 읽을 수 있고 실행할 수 있고 검증할 수 있는 형태로 만들어주느냐에 달려 있다는 것입니다.
실무 쪽에서는 더 직설적인 표현도 나왔습니다. “If you are not the model, you are the harness.”[^1] 모델 자체를 만들지 않는 조직이 개선할 수 있는 영역이 어디인지를 한 문장으로 짚은 말입니다.
[^1]: Vivek Trivedy가 2026년 harness engineering을 설명하며 사용한 ‘Agent = Model + Harness’라는 관점을 옮긴 표현이다
3. 하네스는 무엇으로 이루어지는가
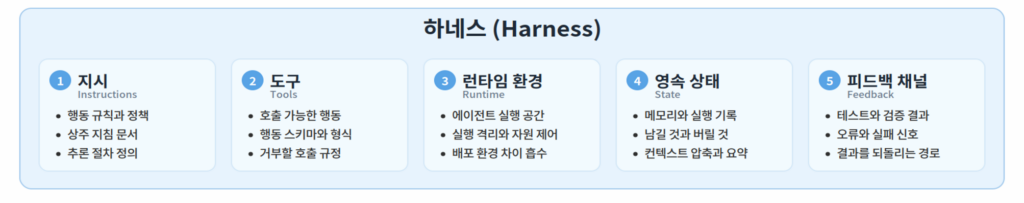
연구와 실무에서 반복적으로 등장하는 요소를 이 글에서는 다섯 가지로 묶어보겠습니다.
- 지시(instructions): 자연어로 표현된 행동 규칙, 과제 정책, 추론 절차입니다. 프롬프트도 여기 포함되지만 하네스 관점에서 지시는 매 요청마다 새로 쓰는 것이 아니라 시스템에 상주하는 규범에 가깝습니다. AGENTS.md 를 지원하는 일부 coding agent에서는 저장소 루트뿐 아니라 하위 디렉토리에 별도 파일을 두어 작업 범위별 지시를 관리할 수도 있습니다.
- 도구(tools): 외부 서비스를 노출하는 창구입니다. 중요한 것은 도구의 존재 자체가 아니라, 도구가 규정하는 행동 스키마, 호출 형식, 검증 규칙입니다. 무엇을 호출할 수 있는지보다 어떤 호출을 거부할 것인지가 하네스의 설계 대상입니다.
- 런타임 환경(runtime environment): 에이전트가 실제로 실행되는 공간입니다. 로컬 개발 환경에서 잘 돌던 에이전트가 프로덕션 인프라로 옮겨가면서 겪는 문제들이 여기에 속합니다.
- 영속 상태(persistent state): 메모리와 실행 기록입니다. 무엇을 남기고 무엇을 버릴지의 문제이며 다음 장에서 다룰 열화 문제의 핵심 무대이기도 합니다.
- 피드백 채널(feedback channels): 행동의 결과가 에이전트에게 되돌아오는 경로입니다. 테스트 실패, 컴파일 오류, 스키마 검증 결과처럼 기계가 판정할 수 있는 신호가 여기 해당합니다. 이 채널이 없으면 에이전트는 자기가 틀렸다는 사실을 알 방법이 없습니다.
4. 프롬프트, 컨텍스트, 하네스
이 셋의 경계는 아직 업계에서 완전히 합의되지 않았습니다. 그래서 글이나 발표를 볼 때 화자가 어떤 정의를 쓰고 있는지 먼저 확인해야 합니다. 대체적인 구분은 다음과 같습니다.
| 구분 | 주로 다루는 대상 | 대표적인 산출물 | 주요 관심사 |
| Prompt engineering | 모델에 어떤 지시를 줄 것인가 | Prompt, few-shot example | 지시 해석과 응답 형태 |
| Context engineering | 모델에게 무엇을 보여줄 것인가 | Retrieval·요약·압축 전략 | 관련 정보의 선택과 구성 |
| Harness engineering | 모델을 어떤 실행 구조 안에서 동작시킬 것인가 | 코드·schema·validator·실행 정책 | 실행 제어·검증·복구·추적 |
하나의 실용적인 관점에서는 셋을 포함 관계로 볼 수 있습니다. 다만 강조점이 다릅니다. 앞의 둘이 모델이 더 잘하게 만드는 일이라면 하네스는 모델이 틀려도 시스템이 버티게 만드는 일입니다.
이 차이는 검증 방식에서 가장 선명하게 드러납니다. 프롬프트에만 의존한 규칙은 모델의 확률적 동작에 영향을 받지만 코드와 스키마, 검증기로 옮긴 규칙은 모델 출력과 독립적으로 강제할 수 있습니다. 반드시 지켜져야 하는 것이 있다면 그것은 프롬프트가 아니라 코드가 소유해야 한다는 것이 하네스 관점의 출발점입니다.
5. 왜 지금인가
하네스가 최근에 주목받는 이유는 에이전트가 다루는 작업의 길이가 늘어났기 때문입니다.
한 번의 질의응답이라면 프롬프트만으로 충분합니다. 그러나 여러 단계에 걸쳐 서로 의존하는 결정을 이어가는 작업에서는 사정이 달라집니다. 초반의 작은 실수나 빠진 정보가 뒤로 갈수록 누적되어 후반의 실패로 자랍니다.
여기서 흔한 오해가 하나 있습니다. 컨텍스트 윈도우를 늘리면 해결되지 않느냐는 것입니다. 컨텍스트 윈도우를 늘리는 것만으로 이 문제가 해결되지는 않습니다. 창을 넓히는 것만으로는 실행 기록에 낡고 중복되고 신호가 약한 정보가 쌓이는 것을 막지 못합니다. 오히려 그런 정보가 판단 품질을 떨어뜨리고 에이전트의 주의를 분산시킵니다. 그래서 실무 하네스들은 궤적 요약, 검색 기반 메모리, 컨텍스트 압축, 재시도 규칙, 도구 호출 검증 같은 장치를 손으로 설계해 넣습니다.
예를 들어 LangChain의 Deep Agents 사례에서는 모델을 유지한 채 환경 컨텍스트, 시간 인식, loop detection, build–verify–fix 구조 등을 개선해 Terminal Bench 2.0 점수를 52.8에서 66.5로 높였다고 보고했습니다.
6. 하네스는 실제로 무엇을 보장하는가
“좋아진다”는 말은 검증 가능해야 의미가 있습니다. 이 지점에서 참고할 만한 연구가 있습니다.
기업용 LLM 에이전트를 대상으로 결정적으로 지켜져야 하는 동작을 프롬프트가 아니라 코드·매니페스트·스키마·검증 산출물로 옮긴 구조를 제안하고 이를 실제로 측정한 연구입니다. 결과는 세 가지로 요약됩니다.
첫째, 하네스가 강제하는 규약들은 고정된 검증 시나리오 전반에서 유지되었고 일부러 규약을 깨뜨린 대조군에서는 검증기가 이를 정확히 잡아냈습니다.
둘째, 해당 실험 범위에서는 모델을 바꿔도 하네스가 강제하는 규약이 유지되었습니다. Ahn과 Kim(2026)은 기업용 LLM agent를 대상으로 세 종류의 호스팅 모델로 바꿔가며 270회를 실행하는 동안 검증 항목은 모두 통과했고 실패는 모델이 담당한 영역에만 국한되어 전부 포착·기록되었습니다.
셋째, 이 보장이 프롬프트만으로는 재현되지 않았습니다. 모델을 고정한 채 강제 계층만 제거했을 때, 프롬프트 지시만으로는 막지 못한 위반이 그대로 최종 결과물까지 도달했습니다. 하네스가 붙어 있을 때는 전부 차단된 항목들입니다.
두 번째 결과가 실무적으로 가장 중요합니다. 모델 교체 주기가 짧아진 지금, 모델을 갈아끼워도 유지되는 보장이 어디에 있는가가 곧 시스템의 신뢰도입니다. 프롬프트에만 의존하는 규칙은 모델 교체에 따라 동작이 달라질 수 있지만 모델 외부의 검증 계층은 동일하게 유지할 수 있습니다.
7. 도입을 검토한다면
아직 정립 중인 분야인 만큼 도입은 전면 재설계보다 경계를 하나씩 긋는 방식이 현실적입니다. 검토할 때 던져볼 만한 질문들입니다.
① 무엇이 반드시 지켜져야 하는가. 출력 형식, 참조 가능한 출처의 범위, 노출되면 안 되는 내부 정보. 이 목록이 곧 코드로 옮겨야 할 대상입니다. 프롬프트에 “반드시”, “절대”라고 적혀 있는 문장들이 대체로 여기 해당합니다.
② 실패를 기계가 판정할 수 있는가. 기계적으로 판정하기 어려운 실패는 결정적 검증 규칙만으로 차단하기 어렵습니다. 따라서 가능한 실패 조건을 schema 위반, 존재하지 않는 출처 인용, 허용되지 않은 tool 호출처럼 검증 가능한 형태로 바꾸는 것이 중요합니다. 스키마 위반, 존재하지 않는 출처 인용, 허용되지 않은 도구 호출처럼 자동으로 판정 가능한 형태로 실패를 정의하는 것이 먼저입니다.
③ 실패했을 때 무엇을 하는가. 재시도할지, 되돌릴지, 사람에게 넘길지를 미리 정해두지 않으면 검증기는 로그만 남기는 장치가 됩니다.
④ 추적할 수 있는가. 어떤 컨텍스트로 무엇을 호출해 어떤 결과를 받았는지가 남아야 개선이 가능합니다. 마이크로서비스 아키텍처(MSA, Microservices Architecture)에서 분산 추적이 필요했던 이유와 같습니다.
⑤ 하네스 자체의 비용은 얼마인가. 이것이 가장 자주 간과되는 항목입니다. 하네스는 공짜가 아니라 유지보수 대상인 코드입니다. 최근에는 하네스를 계속 갱신하는 행위 자체가 곧 성능 향상인지를 분리해서 봐야 한다는 문제 제기도 나오고 있습니다. 규칙을 하나 더 넣기 전에 그 규칙이 실제로 무엇을 막는지 측정할 수 있는지부터 확인하는 편이 좋습니다.
8. 마무리
하네스 엔지니어링은 새로운 기술 스택이라기보다 관점의 이동에 가깝습니다. 에이전트를 “잘 대답하는 모델”이 아니라 “검증 가능한 운영 시스템”으로 보는 시각입니다.
이 시각은 사실 낯설지 않습니다. 분산 시스템에서 우리는 개별 서비스가 항상 성공한다고 가정하지 않고 실패를 전제로 재시도와 보상 트랜잭션과 관측 체계를 설계해왔습니다. 하네스 엔지니어링은 같은 태도를 LLM 에이전트에 적용하는 일입니다. 모델은 확률적으로 동작하는 구성요소이고 그 위에 결정적인 보장을 얹는 것은 우리가 쓰는 코드의 몫입니다.
용어의 경계는 아직 유동적이고 무엇이 하네스에 속하는지에 대한 합의도 진행 중입니다.
방향은 분명해 보입니다. 모델의 성능 곡선이 우리 손 밖에 있는 이상 우리가 설계할 수 있는 것은 그 바깥입니다.
참고 자료
- Ahn, J. & Kim, M., From Prompts to Contracts: Harness Engineering for Auditable Enterprise LLM Agents — https://arxiv.org/abs/2607.08028
- HARBOR: A Harness Framework for Agentic Robot Reinforcement Learning (Appendix B, Background: Harness Engineering) — https://arxiv.org/abs/2606.08610
- HarnessBridge: Learnable Bidirectional Controller for LLM Agent Harness — https://arxiv.org/abs/2606.12882
- SafeHarness: Lifecycle-Integrated Security Architecture for LLM-based Agent Deployment — https://arxiv.org/abs/2604.13630
- AWS 기술 블로그, 「하네스 엔지니어링으로 본 Deep Insight — 로컬 개발에서 프로덕션 운영까지의 설계 여정」 — https://aws.amazon.com/ko/blogs/tech/harness-engineering-from-deep-insight/