1. 들어가며: 쿼리 게시판과 엑셀 컬럼 삭제
고객사 프로젝트를 하면서 “쿼리 게시판”이라는 것을 처음 봤습니다. 자주 쓰는 데이터 추출 쿼리를 게시글로 모아 둔 곳인데, 예를 들어 “전년도 실적 뽑기 쿼리”라는 글에 들어가면 전년도 실적을 뽑는 SQL이 작성되어 있는 형태입니다. 현업 담당자는 필요한 글을 찾아 쿼리를 복사해 실행하는 방식으로 데이터를 얻고 있었습니다. 저희처럼 SQL을 다루는 사람에게는 낯선 장면이지만, 데이터를 직접 다루지 않는 조직에서는 나름 합리적인 방법같아 보이기도 합니다. 다만 게시판에 없는 데이터가 필요하거나, 기간이나 조건을 조금만 바꾸고 싶어도 SQL을 직접 고쳐야 한다는 한계가 있습니다.
그래서 게시판에 원하는 쿼리가 없는 경우에는 다른 방법을 쓰고 있었는데, 담당자는 필요한 데이터가 어느 테이블에 있는지는 대략 알고 있었지만 원하는 컬럼만 골라서 뽑는 방법은 몰랐습니다. 그래서 테이블을 통째로 내려받아 엑셀로 연 다음, 필요 없는 컬럼을 하나씩 지워 가며 사용하고 있었습니다. 수십 개의 컬럼 가운데 실제로 쓰는 것은 서너 개뿐이었습니다.
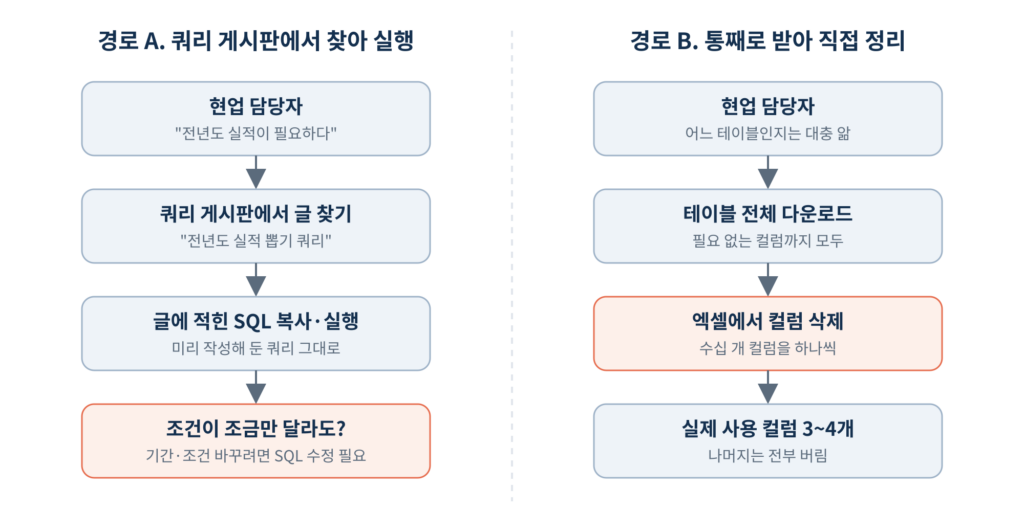
그림 1. 현업 담당자가 데이터를 얻는 두 가지 경로
원하는 데이터는 이미 DB 안에 있고, 없는 것은 ‘꺼내는 방법’뿐. 그렇다면 원하는 것을 말로 설명하기만 하면 데이터를 찾아 주는 기술은 지금 어디까지 와 있을까요? 이 글은 그 질문에서 출발해 조사한 내용을 정리한 것입니다.
결론부터 말씀드리면 다음과 같습니다.
- 자연어를 SQL로 바꾸는 기술(Text-to-SQL)은 깔끔한 예제 DB에서는 90%가 넘는 정확도를 보이지만, 실제 기업 규모의 DB에서는 정확도가 크게 떨어집니다.
- 어려운 부분은 SQL 문법이 아니라, “이 질문에 필요한 데이터가 어느 테이블, 어느 컬럼, 어떤 코드값에 있고, 테이블들은 어떻게 이어지는가“를 찾는 단계, 즉 스키마 링킹(Schema Linking)입니다.
- 그리고 이 단계의 품질은 모델보다 데이터를 설명하는 정보(데이터 사전, 코드 정의, 예시 쿼리, 업무 용어 정의)에 더 크게 좌우됩니다.
2. Text-to-SQL은 어디까지 왔나
Text-to-SQL은 사용자의 자연어 질문을 DB에서 실행할 수 있는 SQL로 바꿔 주는 기술입니다. 오래전부터 연구되어 온 주제이지만, LLM이 등장하면서 실무에 쓸 수 있는 수준까지 빠르게 발전했습니다.
LLM 기반 Text-to-SQL은 보통 세 단계로 나누어 설명합니다. 질문과 관련된 테이블과 컬럼을 찾는 ① 스키마 링킹, 찾은 정보로 쿼리를 만드는 ②SQL 생성, 그리고 만든 쿼리를 실행해 보고 오류가 있으면 고치는 ③검증·실행입니다. 이 가운데 SQL 생성은 LLM이 이미 잘하는 영역으로, 문법에 맞는 SELECT 문을 작성하는 것은 요즘 모델에게 어려운 일이 아닙니다.
간단한 예를 들어 보겠습니다. “작년에 배송이 완료된 주문 수를 지역별로 알려줘”라는 질문이 들어오면, 시스템은 아래와 같은 SQL을 만들어야 합니다. (테이블명과 코드값은 가상의 예시입니다.)
| SELECT c.SIDO_NM AS 지역, COUNT(*) AS 주문수 FROM TB_ORD_MST o JOIN TB_CUST_INFO c ON o.CSTMR_ID = c.CUST_NO WHERE o.ORD_STAT_CD = ’03’ AND o.DLV_CMPL_DT BETWEEN ‘2025-01-01’ AND ‘2025-12-31’ GROUP BY c.SIDO_NM; |
SQL 자체는 단순합니다. 하지만 이 쿼리를 작성하려면 주문 정보가 TB_ORD_MST에 있고, 지역 정보는 고객 테이블에 있으며 두 테이블이 CSTMR_ID와 CUST_NO로 이어진다는 것, ‘배송 완료’가 코드 ’03’이고, ‘작년’은 배송완료일(DLV_CMPL_DT)을 기준으로 한다는 것을 모두 알고 있어야 합니다. 즉, 어려운 것은 SQL 문법이 아니라 이 네 가지를 아는 일입니다.
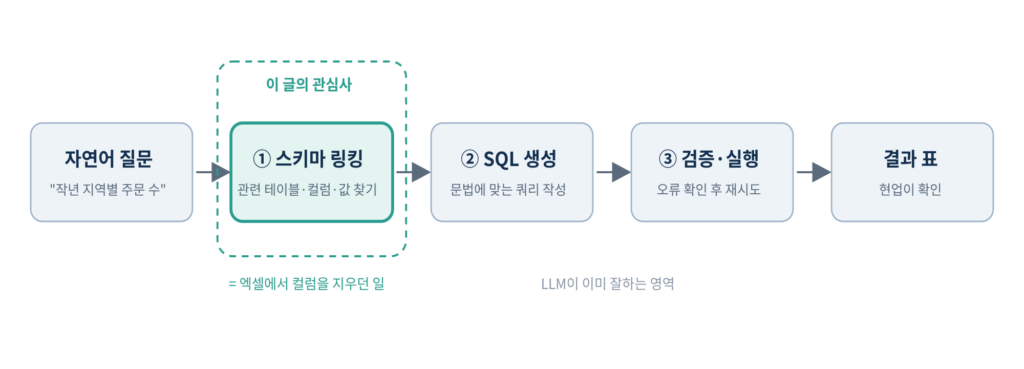
그림 2. Text-to-SQL 파이프라인과 이 글의 관심사
문제는 “실제 DB에서도 잘하느냐”입니다. 연구 커뮤니티에서 많이 쓰는 대표적인 벤치마크 세 가지를 보면 그 흐름을 알 수 있습니다.
| 벤치마크 | 특징 | 규모 |
|---|---|---|
| Spider 1.0 | 학습·평가용으로 만든 소규모 예제 DB | 테이블 몇개짜리 연습용 DB (DB 내 모든 테이블의 컬럼 합계 약 27개 수준) |
| BIRD | 실제 기관 데이터 기반, 지저분한 값과 외부 지식(코드 의미 등) 포함 | 서로 다른 분야의 DB 95개 (전체 33.4GB) |
| Spider 2.0 | 실제 기업 데이터 기반, 여러 SQL 방언과 문서 탐색 필요 | 실제 기업 규모 DB (DB 전체 컬럼 합계 합계 평균 약 800개, 1,000개 넘는 경우도 있음) |
Spider 2.0 논문(ICLR 2025)에 따르면, 기존 벤치마크인 Spider 1.0에서는 91.2%, BIRD에서는 73.0%의 실행 정확도가 보고되었습니다. 하지만 기업 환경을 반영한 Spider 2.0에서는 o1-preview 기반 에이전트가 전체 과제의 21.3%만 해결했고, 기존 방식(DAIL-SQL + GPT-4o)은 Spider 2.0-lite에서 5.68%에 그쳤습니다.
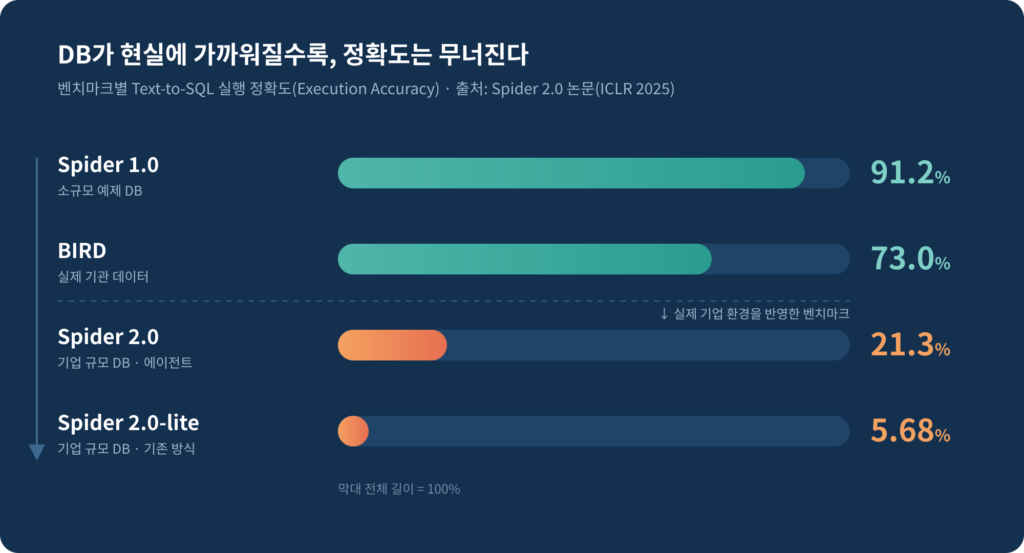
그림 3. 벤치마크별 Text-to-SQL 실행 정확도 비교 (출처: Spider 2.0 논문)
물론 벤치마크 수치를 실제 현장의 정확도로 그대로 옮길 수는 없고, 모델도 계속 좋아지고 있습니다. 그래도 방향은 분명합니다. DB가 커지고, 값이 지저분해지고, 업무 지식이 필요해질수록 정확도는 급격히 떨어집니다. 그리고 공공기관이든 기업이든, 실제 업무 시스템은 대부분 이쪽에 가깝습니다.
3. 진짜 어려운 단계: “그 데이터, 어디 있어요?”
3.1 스키마 링킹이란
스키마 링킹은 질문 속 표현을 DB의 테이블과 컬럼에 연결하는 단계입니다. Text-to-SQL 관련 서베이 논문들은 이 단계가 중요한 이유로 두 가지를 꼽습니다. 첫째, 큰 DB의 테이블 설명을 모두 프롬프트에 넣는 것은 현실적으로 불가능합니다. 둘째, 관련 없는 테이블과 컬럼이 섞여 있으면 LLM이 정답 컬럼을 고르는 데 방해가 됩니다.
앞에서 본 엑셀 장면을 다시 떠올려 보면, 담당자가 컬럼을 하나씩 지우던 일이 사실상 사람이 손으로 하는 스키마 링킹입니다. “이 컬럼은 필요하고, 이건 필요 없다”를 판단하는 일, 바로 이것이 Text-to-SQL에서 시스템이 대신해야 하는 핵심입니다.
3.2 왜 어려운가
조사하면서 정리한 어려움은 크게 네 가지입니다. 아래 예시는 설명을 위한 가상의 값입니다.
| 어려움 | 현업 표현 | DB의 실제 모습 (가상) |
|---|---|---|
| 의미를 알 수 없는 이름 | “주문 상태” | ORD_STAT_CD, COL_07 같은 축약·일련번호 컬럼명 |
| 코드값 해석 | “배송 완료된 주문” | ORD_STAT_CD = ’03’ (03이 ‘배송 완료’라는 건 코드 테이블이나 담당자만 앎) |
| 업무 용어와 DB 구조의 차이 | “작년 주문 수” | ‘작년’의 기준이 주문일인지 배송일인지, 주문 수를 주문 건 기준으로 셀지 상품 기준으로 셀지 |
| 여러 테이블에 흩어진 정보 | “반품이 많은 고객” | 고객·주문·주문상세·반품 테이블을 이어야 하고, 어떻게 잇느냐에 따라 답이 달라짐 (3.3에서 자세히) |
여기에 하나를 더하자면 값 자체가 지저분하다는 문제도 있습니다. 예를 들어 같은 거래처가 ‘(주)○○상사’와 ‘주식회사 ○○상사’로 따로 저장되어 있거나, 날짜가 문자열과 날짜형으로 섞여 있거나, 탈퇴한 회원이 삭제되지 않고 상태값만 바뀌어 있는 경우입니다. BIRD 벤치마크가 실제 기관 데이터의 지저분한 값을 일부러 그대로 둔 것도 이런 현실을 반영하기 위해서입니다. 사람은 몇 번 조회해 보면 이런 사정을 알아차리지만, 시스템은 이를 모르면 그럴듯하지만 틀린 숫자를 내놓게 됩니다.
이런 문제들은 SQL 문법과는 관계가 없습니다. 숙련된 개발자라도 처음 보는 시스템이라면 똑같이 막히게 됩니다. 그래서 고객사에는 쿼리 게시판이 생겼고, 그 게시판에 새 쿼리를 올릴 수 있는 사람은 시스템을 오래 다뤄 본 몇 명뿐입니다.
3.3 가장 큰 벽: 복잡하게 얽힌 테이블 관계
앞의 어려움들은 대부분 “어떤 컬럼을 고를까”의 문제입니다. 그런데 실제 업무 DB에서 스키마 링킹을 가장 어렵게 만드는 것은 테이블들이 어떻게 연결되어 있느냐입니다. 질문 하나에 필요한 정보는 여러 테이블에 흩어져 있고, 필요한 테이블을 찾았더라도 그 테이블들을 어떤 경로로, 어떤 키로 이어야 하는지까지 알아야 올바른 결과가 나옵니다.
예를 들어 “작년에 반품이 많았던 고객은 어느 지역에 있나?”라는 질문을 생각해 보겠습니다. 문장은 짧지만, 답을 구하려면 고객, 주문, 주문상세, 반품이력 테이블을 차례로 이어야 하고, 지역 정보를 어디서 가져올지도 정해야 합니다.
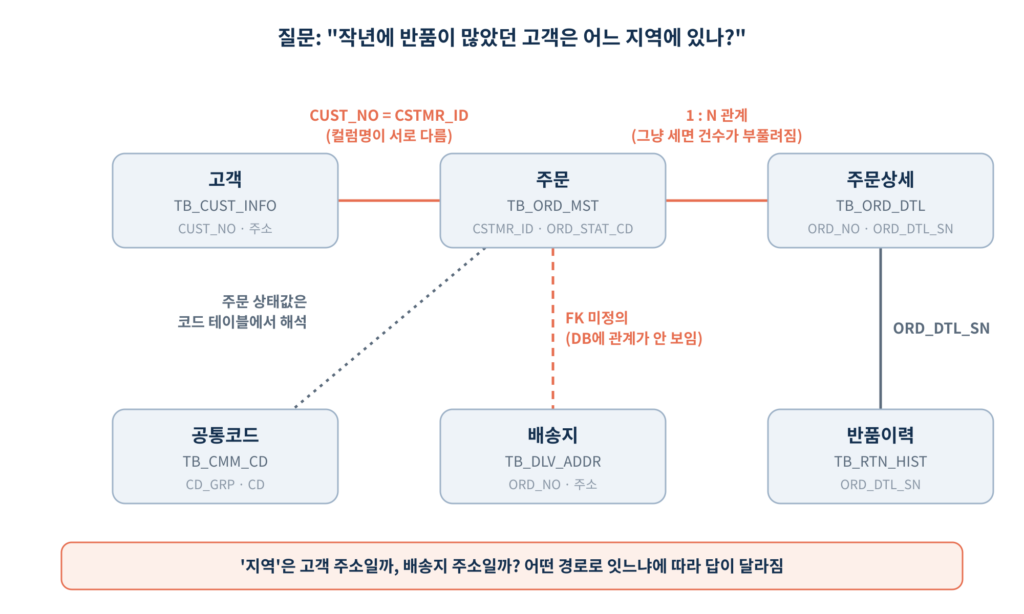
그림 4. 질문 하나에 얽혀 있는 테이블 관계 (가상 예시)
이 과정에서 실제로 부딪히는 문제는 다음과 같습니다.
- 관계가 DB에 드러나 있지 않습니다. 성능이나 레거시 사정으로 외래 키(FK) 제약을 걸지 않고 애플리케이션에서만 관계를 관리하는 시스템이 많습니다. 이 경우 스키마만 봐서는 어떤 테이블이 어떤 테이블과 이어지는지 알 수 없습니다.
- 같은 값인데 컬럼명이 다릅니다. 고객 테이블의 CUST_NO와 주문 테이블의 CSTMR_ID가 같은 값이라는 것은 이름만 봐서는 알기 어렵습니다.
- 연결 경로가 여러 개입니다. ‘지역’을 고객 주소에서 가져올지, 배송지 주소에서 가져올지에 따라 같은 질문도 답이 달라집니다. 어느 경로가 맞는지는 업무 맥락을 알아야 판단할 수 있습니다.
- 잘못 잇으면 숫자가 틀어집니다. 주문과 주문상세처럼 1:N 관계인 테이블을 그냥 조인해서 세면 건수가 부풀려지고, 이력 테이블에서 최신 이력만 골라내지 않으면 같은 대상이 여러 번 집계됩니다. SQL은 오류 없이 실행되기 때문에 틀린 줄도 모르고 지나치기 쉽습니다.
LLM은 테이블과 컬럼 이름이 비슷해 보이면 그럴듯하게 이어 붙이는 경향이 있습니다. 하지만 관계 정보가 없는 상태에서는 그 연결이 맞는지 확인할 방법이 없습니다. 테이블이 수백 개에 이르는 실제 업무 시스템이라면 이 문제는 더 커집니다. 그래서 저는 “어떤 테이블이 필요한가”보다 “그 테이블들을 어떻게 이어야 하는가”가 스키마 링킹에서 더 어려운 문제라고 생각합니다.
3.4 ‘설명 정보’가 정확도를 바꾼다
이 지점에서 인상적이었던 것이 BIRD 벤치마크의 실험입니다. BIRD는 질문마다 “이 코드값은 이런 뜻이다”와 같은 외부 지식 문장(evidence)을 함께 제공하는데, 이 문장이 있을 때와 없을 때 GPT-4의 실행 정확도는 34.88%에서 54.89%로 약 20%p 차이가 났습니다.
같은 모델, 같은 DB인데도 “데이터를 설명하는 한 줄”이 있느냐 없느냐에 따라 정확도가 크게 달라진 것입니다. 다만 BIRD의 evidence는 전문가가 질문마다 직접 작성한 것이어서, 실제 운영 환경과는 차이가 있다는 지적도 있습니다. 실무에서는 질문마다 힌트를 써 줄 사람이 없기 때문에, 이런 정보를 미리 정리해 두고 시스템이 찾아 쓰도록 만들어야 합니다. 다음 장에서 소개할 접근 방식들도 대부분 이 고민에서 나온 것입니다.
4. 접근 방식: 데이터를 ‘찾게’ 만드는 방법들
4.1 스키마를 줄여서 보여주기 (Schema RAG)
가장 기본적인 방법은 질문과 관련 있어 보이는 테이블과 컬럼만 골라서 LLM에 넘기는 것입니다. 테이블과 컬럼 설명을 벡터 DB에 넣어 두고, 질문이 들어오면 유사도 검색으로 후보를 추려 내는 방식입니다. RAG를 문서 대신 스키마에 적용한다고 보면 됩니다. 실제로 최근의 Text-to-SQL 연구 정리에서도 RAG를 스키마 이해와 용어의 모호성 해소에 활용하는 흐름을 별도로 다루고 있습니다.
4.2 데이터 사전·코드 정의·테이블 관계 정비
검색이 잘 되려면 우선 검색할 내용이 있어야 합니다. 컬럼명이 “COL_07” 이런 식이라면 어떤 검색 기법도 소용이 없습니다. 그래서 테이블과 컬럼의 업무 의미, 코드값의 실제 뜻을 정리한 데이터 사전이 사실상의 출발점이 됩니다. 구축 프로젝트를 거친 시스템에는 산출물로 테이블 정의서나 코드 정의서가 이미 있는 경우가 많기 때문에, 이를 활용할 수 있다는 점은 오히려 기회라고 생각합니다.
코드와 컬럼의 의미만큼 중요한 것이 테이블 간 관계 정보입니다. DB에 FK가 정의되어 있지 않더라도, 어떤 테이블이 어떤 키로 이어지는지를 따로 정리해 두면 시스템이 이를 그래프처럼 활용해 필요한 테이블 사이의 연결 경로를 찾을 수 있습니다. 실제로 스키마 링킹 연구에서도 질문과의 유사도뿐 아니라 테이블 간 연결 관계를 함께 활용하는 방법이 다뤄지고 있습니다. 더 현실적인 방법은 자주 쓰는 조인을 아예 조회용 뷰로 만들어 두는 것입니다. 시스템이 복잡한 조인을 직접 추론하는 대신 검증된 뷰를 기준으로 데이터를 찾게 하면, 숫자가 틀어질 위험을 크게 줄일 수 있습니다.
4.3 예시 질문-쿼리 쌍 활용
자주 들어오는 질문과 그에 맞는 검증된 SQL을 쌍으로 모아 두었다가, 비슷한 질문이 들어오면 예시로 함께 넘기는 방법입니다. 저희 고객사처럼 쿼리 게시판이 있는 조직이라면 게시판에 쌓인 글 제목과 SQL 자체가 좋은 예시 데이터가 될 수 있습니다. “전년도 실적 뽑기 쿼리”라는 제목이 질문이고, 본문의 SQL이 그 답이기 때문입니다. 사람이 손으로 모아 온 지식이 그대로 시스템의 재료로 이어지는 셈입니다.
4.4 업무 용어와 지표 정의 (시맨틱 레이어)
“반품률”이나 “평균 배송 기간”처럼 계산식이 들어가는 지표는 매번 LLM이 해석하도록 두기보다 미리 정의해 두는 편이 안전합니다. 업무 용어를 테이블, 컬럼, 계산식과 연결해 둔 계층을 보통 시맨틱 레이어라고 부릅니다. 이렇게 해 두면 LLM은 “반품률”을 새로 해석할 필요 없이, 정의된 지표를 가져다 쓰기만 하면 됩니다.
4.5 에이전트형 탐색
Spider 2.0이 보여 준 또 하나의 흐름은 ‘한 번에 SQL을 만드는 방식’에서 ‘탐색하며 만드는 방식’으로의 전환입니다. 에이전트가 테이블 목록을 조회하고, 샘플 데이터를 확인하고, 쿼리를 실행해 결과를 보면서 스스로 고쳐 나가는 방식입니다. Spider 2.0-snow 과제에서 에이전트 방식(ReFoRCE)은 26.69%, 기존 방식(DAIL-SQL + GPT-4o)은 2.20%로, 같은 과제에서도 차이가 컸습니다. 다만 실행 횟수만큼 응답 시간과 비용이 늘어나고, 운영 DB에 반복 조회가 일어난다는 점은 고려해야 합니다.
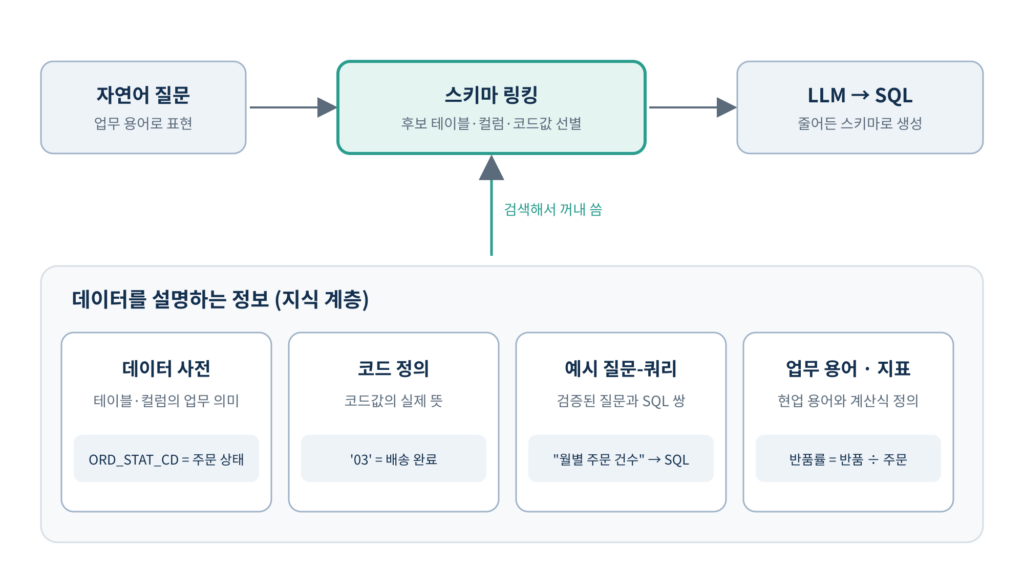
그림 5. 스키마 링킹을 돕는 ‘데이터를 설명하는 정보’ 계층
지금까지의 내용을 정리하면 다음과 같습니다.
| 방식 | 핵심 아이디어 | 준비할 것 | 한계 |
|---|---|---|---|
| Schema RAG | 관련 테이블·컬럼만 골라 전달 | 테이블·컬럼 설명, 벡터 검색 | 설명이 부실하면 검색 실패 |
| 데이터 사전·코드 정의 | 이름과 코드값에 의미 부여 | 테이블 정의서, 코드 정의서 | 정비에 사람 손이 많이 듦 |
| 예시 질문-쿼리 | 검증된 사례를 참고 | 질문-SQL 쌍 (게시판 이력 등) | 처음 보는 유형의 질문엔 약함 |
| 시맨틱 레이어 | 업무 용어·지표를 미리 정의 | 용어 사전, 지표 계산식 | 정의 범위 밖 질문은 처리 못 함 |
| 에이전트형 탐색 | 조회·실행하며 스스로 확인 | 안전한 실행 환경 | 응답 시간·비용·DB 부하 |
이 방식들은 서로를 대체하는 관계가 아닙니다. 공통점은 결국 데이터를 설명하는 정보가 좋을수록 잘 동작한다는 것입니다.
5. 실제 도입 시 생각해 볼 점
공공기관 뿐 아니라 기업의 업무 시스템도 폐쇄망으로 운영되거나 보안 정책상 데이터를 외부로 보내기 어려운 경우가 많습니다. 이런 환경에서는 외부 클라우드 LLM을 그대로 쓰기 어렵기 때문에 실제 도입을 염두에 두고 함께 고민한 점들을 적어보겠습니다.
모델 선택. 외부 API를 쓸 수 없다면 사내에 직접 띄울 수 있는 경량 모델(sLLM)을 검토해야 합니다. 앞에서 본 것처럼 정확도는 모델 크기보다 스키마 정보의 품질에 크게 좌우되기 때문에, 작은 모델이라도 스키마 링킹을 잘 받쳐 주면 쓸 만한 수준을 기대해 볼 수 있다고 생각합니다.
권한과 안전. 생성된 SQL을 그대로 운영 DB에서 실행하는 것은 위험합니다. 읽기 전용 계정, 조회 전용 뷰, 개인정보 컬럼 마스킹, 조회 건수 제한 같은 장치가 기본적으로 필요합니다. DB에 접근하는 시스템이라면 더욱 신경 써야 할 부분입니다.
결과 확인 과정. 현업 사용자는 SQL을 읽고 검증하기 어렵습니다. 그래서 생성된 SQL을 그대로 보여 주는 것만으로는 부족하고, SQL을 모르는 사용자도 결과가 의도대로 나왔는지 판단할 수 있도록 돕는 장치가 필요합니다. 이 부분은 기술보다 사용자 경험 설계에 가까운 문제이지만, 실제 현장에서 쓰이느냐 마느냐를 가르는 지점이라고 생각합니다.
평가 방법. 도입을 검토한다면 먼저 “얼마나 맞는가”를 잴 수 있어야 합니다. 벤치마크에서 쓰는 실행 정확도(Execution Accuracy)는 생성한 SQL의 실행 결과가 정답 SQL의 결과와 같은지를 봅니다. 실무에서는 쿼리 게시판처럼 이미 검증된 질문-SQL 쌍이 있다면 그대로 평가셋으로 쓸 수 있습니다. 여기에 스키마 링킹만 따로 떼어 “필요한 테이블과 컬럼을 제대로 골랐는가”를 함께 보면, 틀렸을 때 그 원인이 데이터를 못 찾은 것인지, 찾고도 SQL을 잘못 작성한 것인지 구분할 수 있습니다.
6. 마치며
쿼리 게시판과 엑셀 컬럼 삭제 사례를 보면서 시작한 조사였지만, 정리하고 나니 질문이 조금 바뀌었습니다. 처음에는 “LLM이 SQL을 얼마나 잘 짜는가”가 궁금했는데, 실제로 중요한 것은 “시스템이 우리 데이터를 얼마나 잘 이해하고 있는가“였습니다.
SQL 생성은 마지막 한 걸음입니다. 그 앞에서 질문을 올바른 테이블과 컬럼, 코드값에 연결하는 일이 어려움의 대부분을 차지하고, 그 일을 가능하게 하는 것은 결국 데이터를 설명하는 정보입니다. 현업 담당자가 엑셀에서 컬럼을 지우던 시간이 사라지려면, 그 판단에 필요한 지식이 먼저 어딘가에 정리되어 있어야 합니다.
고객 기관에 이 방향을 고도화 아이디어로 제안하면서도 같은 점을 느꼈습니다. 이런 기술은 모델이나 화면을 붙이는 것만으로 완성되지 않고, 그 전에 기관의 데이터를 정리하는 작업이 함께 따라와야 합니다. 테이블과 컬럼의 의미, 코드값, 테이블 간 관계를 정리하는 일은 시간이 드는 작업이지만, 한번 정리해 두면 Text-to-SQL뿐 아니라 데이터 활용 전반의 기반이 됩니다. 그래서 도입을 검토한다면 기술 검증과 함께 데이터 정비를 첫 단계로 계획하는 것이 현실적이라고 생각합니다.
이 글은 직접 검증한 결과가 아니라 조사한 내용을 정리한 것입니다. 기회가 된다면 실제 업무 시스템과 비슷한 구조의 DB로 작은 PoC를 진행해 보고, 데이터 사전의 유무에 따라 정확도가 얼마나 달라지는지 확인한 결과를 공유해 보겠습니다.
참고자료
- Lei et al., “Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows”, ICLR 2025. https://arxiv.org/abs/2411.07763 (기업 환경 Text-to-SQL 벤치마크와 정확도 수치)
- Li et al., “Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs”, NeurIPS 2023. 논문: https://arxiv.org/abs/2305.03111, 공식 사이트: https://bird-bench.github.io (BIRD 벤치마크, 외부 지식 유무에 따른 정확도 차이)
- “A Survey on Employing Large Language Models for Text-to-SQL Tasks”. https://arxiv.org/abs/2407.15186 (스키마 링킹의 정의와 필요성)
- Liu et al., “A Survey of Text-to-SQL in the Era of LLMs: Where are we, and where are we going?”. https://arxiv.org/abs/2408.05109 (Text-to-SQL 전체 흐름 정리, NL2SQL Handbook)
- “From Natural Language to SQL: Review of LLM-based Text-to-SQL Systems”. https://arxiv.org/abs/2410.01066 (RAG를 활용한 스키마 이해 보완)