1. 들어가며
많은 기업이 사내 규정, 매뉴얼, 보고서를 바탕으로 질문에 답하는 시스템을 만들고 있다. 대부분 검색 증강 생성(RAG, Retrieval-Augmented Generation) 구조로, 대규모 언어 모델(LLM, Large Language Model)이 답하기 전에 관련 문서를 찾아 함께 넣어 준다.
그런데 “문서에 있는 내용인데 엉뚱하게 답한다”는 문제가 자주 생긴다. 원인은 LLM보다 검색 순서인 경우가 많다. 정답 문단을 찾고도 순위가 밀려 LLM에 전달되지 않는 것이다. 이 순서를 바로잡는 단계가 재순위화(Reranking)다.
이 글은 재순위화의 구조와 발전, 잘 쓰는 방법, 리랭커 선정 기준을 정리하고, 2024~2026년에 나온 재순위화 모델 10개를 한국어 기업 문서로 직접 비교한 결과를 공유한다. 1차 검색 4종도 함께 비교했고, 위키백과로도 같은 비교를 해 데이터에 따라 결과가 어떻게 달라지는지 확인했다.
- 기업 문서: 금융·공공·의료·법률·커머스 분야의 실제 PDF로 만든 Allganize 한국어 RAG 평가 데이터[1]
- 위키백과: 검색 평가에 널리 쓰이는 MIRACL 한국어 데이터[2]
이 글의 핵심은 세 가지다.
- 효과는 확실하다. 기업 문서에서 1위 문단이 정답인 비율이 70.9% → 최대 87.8%로 올랐다.
- 데이터가 바뀌면 순위가 뒤집힌다. 기업 문서 1위 모델이 위키백과에서는 7위였다.
- 꼭 크다고 좋지만은 않다. 한국어 특화 모델(매개변수 17억 개, 1.7B)이 8B(80억 개) 모델 성능의 98%를 3분의 1 시간에 냈다.
2. 재순위화란
2.1 재순위화가 하는 일
1차 검색은 검색 점수나 임베딩 유사도로 문서의 순위를 정한다. 하지만 점수가 높다고 해서 질문에 가장 맞는 문서라는 보장은 없다.
예를 들어 ‘청년 전세자금 대출의 신청 자격’을 물으면, 신청 자격을 설명한 문서보다 청년 주거 정책 전반을 다룬 문서가 위에 오를 수 있다. 단어와 주제는 비슷하지만 질문에 대한 답은 없는 문서다.
재순위화(Reranking)는 1차 검색이 가져온 후보 문서의 관련도를 다시 평가해 순서를 다시 매기는 단계다.
단, 재순위화는 후보 안에서 순서만 바꾸므로 1차 검색에서 빠진 문서는 찾을 수 없다.
2.2 RAG 시스템에서 재순위화의 위치
RAG는 질문과 관련된 문서를 먼저 찾고, 이를 바탕으로 LLM이 답을 만드는 방식이다. 일반적인 RAG 시스템은 세 단계로 이뤄지며, 단계마다 다른 모델이 따로 돌아간다(표 1, 그림 1).
| 단계 | 하는 일 | 대표 기술 |
| 1차 검색 (Retrieval) | 문서 수십만 건에서 질문과 관련된 후보 10~20건을 빠르게 고른다 | BM25(Best Matching 25), 임베딩 검색, 하이브리드 검색 |
| 재순위화 (Reranking) | 후보의 관련도를 다시 평가해 순서를 다시 매긴다 | 크로스 인코더, LLM 기반 재순위화 모델 |
| 답변 생성 (Generation) | 상위 몇 건을 읽고 답을 쓴다 | LLM |
[표 1] RAG 시스템의 단계와 대표 기술
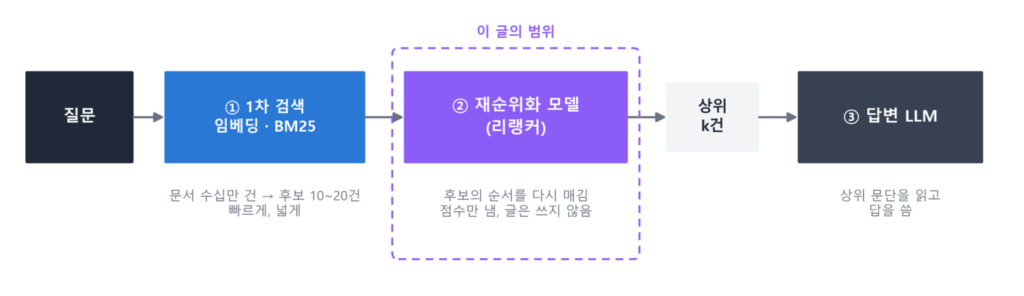
[그림 1] 1차 검색 → 재순위화 → 답변 LLM
재순위화는 1차 검색과 답변 생성 사이에서, 답변 LLM에 넘길 문서의 순서를 바로잡는다.
3. 재순위화 기술의 발전
재순위화는 세 세대를 거쳐 발전했고, 2025년부터는 새로운 흐름이 나타나고 있다(표 2).
1세대 규칙·점수 기반(~2018): 1차 검색에서 쓰는 BM25 점수에 최신성, 클릭 수 같은 점수를 가중치로 더해 순서를 다시 매겼다. 이런 점수들을 학습해 정렬하는 순위 학습(LTR, Learning to Rank)도 검색 엔진에서 널리 썼다. 빠르지만 질문과 문서의 의미를 직접 비교하지는 못한다.
2세대 크로스 인코더(Cross-encoder, 2019~): BERT(Bidirectional Encoder Representations from Transformers) 계열 모델로 질문과 문서를 이어 붙여 함께 읽고 관련도를 판단한다. 지금도 가장 널리 쓰이며, bge-reranker-v2-m3는 한 달에 1,400만 회 이상 내려받는 기본 선택지다[3].
3세대 LLM 기반(2023~): LLM의 문맥 이해력을 재순위화에 쓴다. 문서마다 ‘관련 있는가’를 물어 ‘예’의 확률을 점수로 쓰는 점수형(Qwen3-Reranker)과, 후보 목록 전체를 주고 순서를 매기게 하는 목록형(RankGPT)이 있다.
최근 흐름(2025~): 두 방향으로 나아가고 있다. 하나는 판단 전에 단계적으로 생각하는 추론형(Rank1, ReasonRank)으로, 복잡한 질문에 강하지만 느리다. 다른 하나는 경량·특화로, 한국어(KURE-Reranker)나 문서 이미지(Nemotron-3.5-Rerank-8B)에 맞추거나 문서를 압축해 빠르게 만든다(KaLM-Reranker).
| 세대 | 주요 기술·모델 | 특징 | 한계 |
| 1세대 규칙·점수 기반 (~2018) | BM25 가중합, 순위 학습(LTR) | 키워드·점수로 빠르게 정렬 | 의미를 이해하지 못함 |
| 2세대 크로스 인코더 (2019~) | BERT, bge-reranker-v2-m3 | 질문과 문서를 함께 읽고 의미 관계 판단 | 복잡한 판단에 약함 |
| 3세대 LLM 기반 (2023~) | 점수형 Qwen3-Reranker, 목록형 RankGPT | LLM의 문맥 이해력으로 정확도 향상 | 크고 느림 |
| 최근 흐름 (2025~) | 추론형 Rank1, 특화 KURE-Reranker·Nemotron, 경량 KaLM-Reranker | 복잡한 질문 대응, 한국어·이미지 특화, 경량화 | 검증 사례가 적음 |
[표 2] 재순위화 기술의 세대별 발전
4. 재순위화를 잘 쓰려면
모델만큼 주변 설정이 결과를 좌우한다. 아래 수치는 6장 기업 문서 실험(질문 230개)에서 나왔다.
4.1 1차 검색: 정답을 후보에 넣는 것이 먼저
1차 검색 4종을 따로 비교했다(표 3). 단어 일치를 세는 BM25, 다국어 임베딩 bge-m3, 한국어 임베딩 KURE-v1, 그리고 BM25와 KURE-v1의 순위를 합친 하이브리드 검색이다. 하이브리드 검색은 RRF(Reciprocal Rank Fusion) 방식으로, 두 검색 모두에서 위에 오른 문단을 앞으로 올린다.
후보 20건 안에 정답이 들어간 비율(정답이 후보 안에 하나라도 있는 질문 수 ÷ 전체 질문 수)과, 1차 검색 순서 그대로 매긴 nDCG@10(normalized Discounted Cumulative Gain)을 봤다. nDCG@10은 상위 10건 안에서 정답을 얼마나 위에 놓았는지를 0~1로 나타낸다(계산식은 6.1절).
| 1차 검색 | 종류 | 후보 20건 안에 정답이 들어간 비율 | nDCG@10 (1차 검색만) |
| BM25 | 단어 일치 계산 (형태소 단위) | 95.2% | 0.625 |
| bge-m3 | 다국어 임베딩 모델 | 95.2% | 0.612 |
| KURE-v1 | 한국어 임베딩 모델 | 96.1% | 0.649 |
| 하이브리드 검색 | 단어 일치 + 한국어 임베딩 (RRF) | 96.1% | 0.659 |
[표 3] 1차 검색 비교
- 후보에 넣는 비율은 비슷했다. 네 방식 모두 정답을 후보 20건 안에 95~96% 넣었다.
재순위화는 후보 안에서만 순서를 고친다. 그래서 1차 검색은 정답을 후보 안에 넣는 것이 먼저다. 정답이 후보에 없으면 어떤 재순위화 모델도 찾을 수 없다.
4.2 후보는 10~20건
10건 → 20건: nDCG@10이 0.03~0.04 올랐다.
20건 → 50건: 0.01 안팎만 올랐다.
처리 시간은 후보 수에 비례하므로 10~20건이 적당하다. 응답 속도가 중요하면 10건, 정확도가 중요하면 20건을 쓰고, 20건을 넘기면 시간만 늘고 효과는 미미한 것으로 나타났다(그림 2).
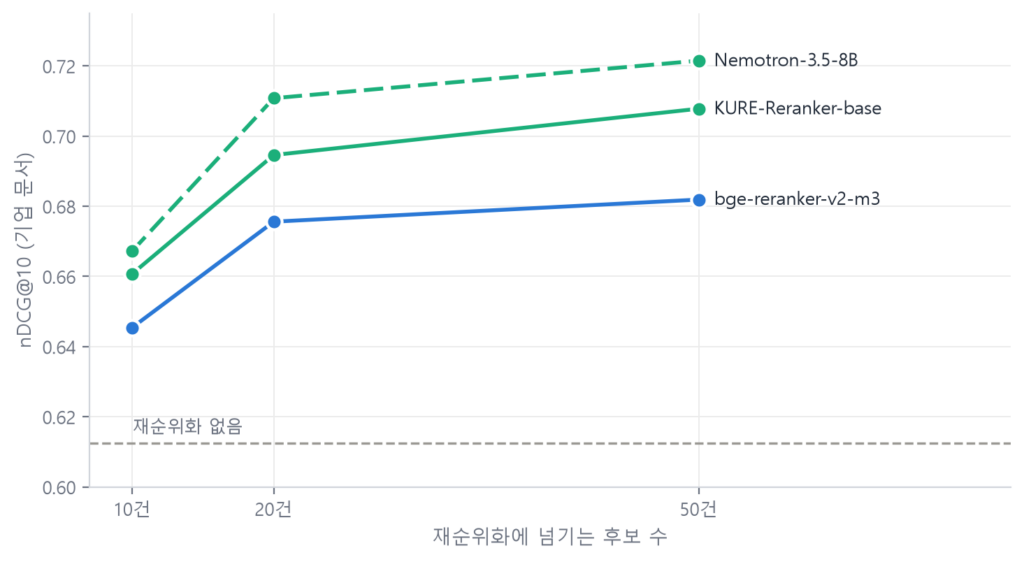
[그림 2] 재순위화 후보 수에 따른 nDCG@10 변화
4.3 전처리: 글자부터 확인한다
문제: 실험에 쓴 기업 문서 1,450쪽 중 100쪽은 스캔 이미지라 글자가 없었고, 표나 그림 속 답은 찾기 어려웠다.
대책: 글자 추출 상태를 확인하고 표를 문장으로 풀어 둔다. 이런 전처리가 모델 교체만큼 효과가 있을 수 있다.
멀티모달: 표와 그림이 많다면 문서 이미지를 직접 읽는 재순위화 모델도 시험해 볼 만하다. 이 글의 실험은 10개 모델을 같은 조건에서 비교하려고 모두 글자만 넣었다(이미지를 읽는 모델은 Nemotron 하나뿐).
4.4 자기 데이터로 평가한다
공개 데이터의 순위는 내 문서에서 그대로 나오지 않는다(6.5절). 모델을 고르기 전에 자기 문서로 작은 시험지를 만들어 직접 채점해 보는 것이 좋다.
- 질문 만들기: 실제로 나올 법한 질문 30~300개 (예: “출장비 정산은 며칠 안에 해야 하나요?”)
- 정답 표시: 질문마다 답이 들어 있는 문단 (예: 출장규정 제12조)
- 채점: 후보 모델 2~3개에 같은 질문을 넣고 nDCG@10과 1위 정답률로 비교
한 번 만들어 두면 새 모델이 나올 때마다 같은 기준으로 다시 비교할 수 있다.
5. 재순위화 모델을 고를 때 볼 것
모델 카드의 점수는 출발점일 뿐이다. 다음 항목을 함께 본다.
| 항목 | 확인할 것 |
| 정확도 | 내 데이터와 비슷한 벤치마크 점수, 가능하면 직접 측정한 점수 |
| 언어 | 한국어 학습 여부. 다국어 모델도 한국어 비중에 따라 차이가 큼 |
| 크기·속도 | 필요한 GPU(Graphics Processing Unit) 메모리와 질문당 처리 시간 |
| 입력 길이 | 한 번에 읽는 문서 길이. 긴 규정·계약서를 다룬다면 중요 |
| 라이선스 | 상업적 이용 가능 여부. 비상업(CC-BY-NC 등) 모델 주의 |
| 운영 형태 | 사내 설치형 공개 모델인지, 외부 API(Application Programming Interface)인지. 폐쇄망이면 공개 모델만 가능 |
[표 4] 재순위화 모델 선정 기준
이 글의 실험도 이 기준으로 후보를 추렸다. 상업적 이용이 가능하고(라이선스), GPU 24GB 1장에 올라가는(크기) 모델 중 2024~2026년 대표 모델과 한국어 특화 모델을 골랐다.
6. 모델별 벤치마크: 직접 비교한 결과
6.1 실험 설계
모든 모델에 같은 후보를 주고, 순서를 얼마나 잘 고치는지 비교했다. 비교한 모델은 표 5, 실험 구성은 표 6과 같다.
비교 대상: 실무에서 주로 쓰는 크로스 인코더 3종과 LLM 기반 7종으로 재순위화 모델 총 10종을 비교했다.
1차 검색: 널리 쓰는 다국어 임베딩 bge-m3로 질문마다 후보 20건을 뽑아 고정했다.
| 모델 | 공개 | 방식 | 크기 | 언어 | 라이선스 |
| bge-reranker-v2-m3 | 2024-03 | 크로스 인코더 | 0.57B | 다국어 | Apache-2.0 |
| bge-reranker-v2-m3-ko | 2024-10 | 크로스 인코더 | 0.57B | 한국어 | Apache-2.0 |
| Qwen3-Reranker-0.6B | 2025-05~06 | LLM 기반 | 0.6B | 다국어 | Apache-2.0 |
| Qwen3-Reranker-4B | 2025-05~06 | LLM 기반 | 4B | 다국어 | Apache-2.0 |
| Qwen3-Reranker-8B | 2025-05~06 | LLM 기반 | 8.2B | 다국어 | Apache-2.0 |
| KURE-Reranker-nano | 2026-09 | 크로스 인코더 | 0.15B | 한국어 | Apache-2.0 |
| KURE-Reranker-base | 2026-09 | LLM 기반 | 1.7B | 한국어 | Apache-2.0 |
| KaLM-Reranker-V1-Nano-R2 | 2026-08 | LLM 기반 | 0.27B | 다국어 | Apache-2.0 |
| KaLM-Reranker-V1-Large-R2 | 2026-08 | LLM 기반 | 4B | 다국어 | Apache-2.0 |
| Nemotron-3.5-Rerank-8B | 2026-10 | LLM 기반 | 8.4B | 다국어 | OpenMDW-1.1 (상업 이용 가능) |
[표 5] 비교한 재순위화 모델 10종 (Hugging Face 모델 카드)
| 항목 | 설정 |
| 데이터 | Allganize 한국어 RAG 평가 데이터[1]: 금융·공공·의료·법률·커머스 PDF 63종, 질문 230개, 500자 조각 3,433개 |
| 비교 대상 | 재순위화 모델 10종(표 5)과 기준점인 ‘재순위화 없음'(bge-m3 1차 검색 순서 그대로) |
| 지표 | nDCG@10, 1위 정답률, 후보 20건 처리 시간, GPU 메모리 |
| 실행 환경 | NVIDIA L4 GPU(24GB) 1장, bf16(16비트), 입력 최대 512토큰 |
| 의미 있는 차이 | 같은 질문끼리 짝지은 부트스트랩 1만 회, 95% 신뢰구간 기준 |
[표 6] 실험 구성
평가 지표는 두 가지다. 계산식은 식 1과 같다.
nDCG@10: 상위 10건 안에서 정답을 얼마나 위에 놓았는지(0~1)[4]. 답변 LLM에 상위 5~10건을 넘기는 구성이라면 이 값을 본다.
1위 정답률: 맨 위 문단이 정답인 질문의 비율. 답변 LLM에 맨 위 1~2건만 넘기는 구성이라면 이 값을 본다.

[식 1] 평가 지표 계산식 (rel(i): i위 문단이 정답이면 1, 아니면 0)
예를 들어 정답이 1개인 질문은 정답이 1위면 nDCG@10이 1.0, 2위면 0.63, 3위면 0.5, 10위 밖이면 0이다. 정답은 질문의 근거가 된 쪽에서 나온 조각으로 표시했고, 두 지표 모두 질문마다 계산해 230개의 평균을 냈다. 재순위화 없음의 1위 정답률은 163 ÷ 230 = 70.9%다.
6.2 실험 코드
실험은 아래 흐름으로 했다. 실제 실험 코드에서 핵심만 줄였다(코드 1).
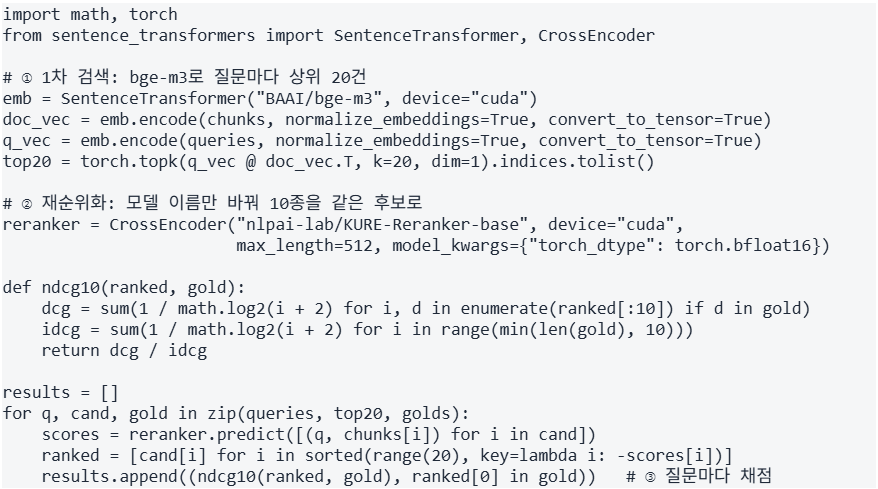
[코드 1] 실험 코드 요약: 1차 검색 → 재순위화 → 채점
① 1차 검색: 문서 조각 3,433개와 질문 230개를 bge-m3로 벡터로 바꾸고, 질문마다 가장 가까운 상위 20건을 고른다. 10개 재순위화 모델은 모두 이 같은 후보를 받는다.
② 재순위화: 모델 이름만 바꿔 10종을 같은 방식으로 돌렸다. 질문과 후보를 한 쌍씩 넣어 관련도 점수를 받고, 점수 순으로 다시 줄 세운다. bf16과 입력 512토큰은 표 6 설정과 같다. LLM 기반 모델도 같은 CrossEncoder로 불러온다(일부는 trust_remote_code=True 필요).
③ 채점: 다시 줄 세운 순서로 질문마다 nDCG@10과 1위 정답 여부를 계산하고, 230개를 평균 낸다. 처리 시간은 질문 50개를 각각 3번씩 재서(예열 후) 질문별 가운데 값을 구하고, 그 50개의 중간값을 썼다. GPU 메모리는 실행 중 최대 사용량이다.
6.3 결과
| 모델 | 공개연도 | nDCG@10 | 1위 정답률 | 처리 시간(ms) | GPU(GB) |
| 재순위화 없음 | – | 0.612 | 70.9% | – | – |
| bge-reranker-v2-m3 | 2024 | 0.676 | 82.6% | 132 | 1.3 |
| bge-reranker-v2-m3-ko | 2024 | 0.689 | 87.0% | 130 | 1.3 |
| Qwen3-Reranker-0.6B | 2025 | 0.666 | 80.0% | 504 | 1.4 |
| Qwen3-Reranker-4B | 2025 | 0.686 | 82.6% | 1,971 | 8.3 |
| Qwen3-Reranker-8B | 2025 | 0.689 | 86.5% | 3,390 | 16.6 |
| KURE-Reranker-nano | 2026 | 0.675 | 82.6% | 117 | 0.5 |
| KURE-Reranker-base | 2026 | 0.695 | 87.8% | 950 | 3.9 |
| KaLM-Reranker-V1-Nano-R2 | 2026 | 0.664 | 78.7% | 272 | 2.8 |
| KaLM-Reranker-V1-Large-R2 | 2026 | 0.689 | 83.0% | 1,877 | 15.5 |
| Nemotron-3.5-Rerank-8B | 2026 | 0.711 | 86.5% | 2,987 | 17.0 |
[표 7] 재순위화 모델별 성능 (후보 20건)
1위 Nemotron-3.5-Rerank-8B(2026, 8.4B): nDCG@10 0.711로 가장 높았다.
2위 KURE-Reranker-base(1.7B): 1위 점수의 98%를 3분의 1 시간, 4분의 1 메모리로 냈고, 1위 정답률은 87.8%로 가장 높았다.
공동 3위 bge-reranker-v2-m3-ko(2024, 0.57B): Qwen3-Reranker-8B·KaLM-Reranker-V1-Large-R2와 같은 0.689였지만, 0.13초·1.3GB로 훨씬 가볍다.
6.4 재순위화는 모든 모델에서 효과가 있었다
nDCG@10: 10개 모델 모두 재순위화 없음(0.612)보다 의미 있게 좋았다(+0.05~0.10). 상위권(0.69~0.71)은 점수 차가 작았다.
1위 정답률: 70.9% → 78.7~87.8%. 답변 LLM에 맨 위 1~2건만 넘기는 구성이라면, 정답을 놓치는 질문이 10개 중 3개에서 1개 남짓으로 준다.
비용: 처리 시간은 최대 29배, GPU 메모리는 최대 34배 차이 났다. 점수가 비슷하다면 응답 속도와 GPU 여건까지 함께 두고 고르는 것이 좋다.
6.5 데이터가 바뀌면 순위가 뒤집힌다
같은 10종을 위키백과(MIRACL 한국어 개발 세트[2], 질문 213개, 문단 30만 개)로도 비교해 봤다. 모델 순위는 크게 달랐다(그림 3).
Nemotron-3.5-Rerank-8B: 기업 문서 1위 → 위키백과 7위
Qwen3-Reranker-0.6B: 위키백과 1위 → 기업 문서 9위
bge-reranker-v2-m3-ko: 기업 문서 공동 3위 → 위키백과 꼴찌
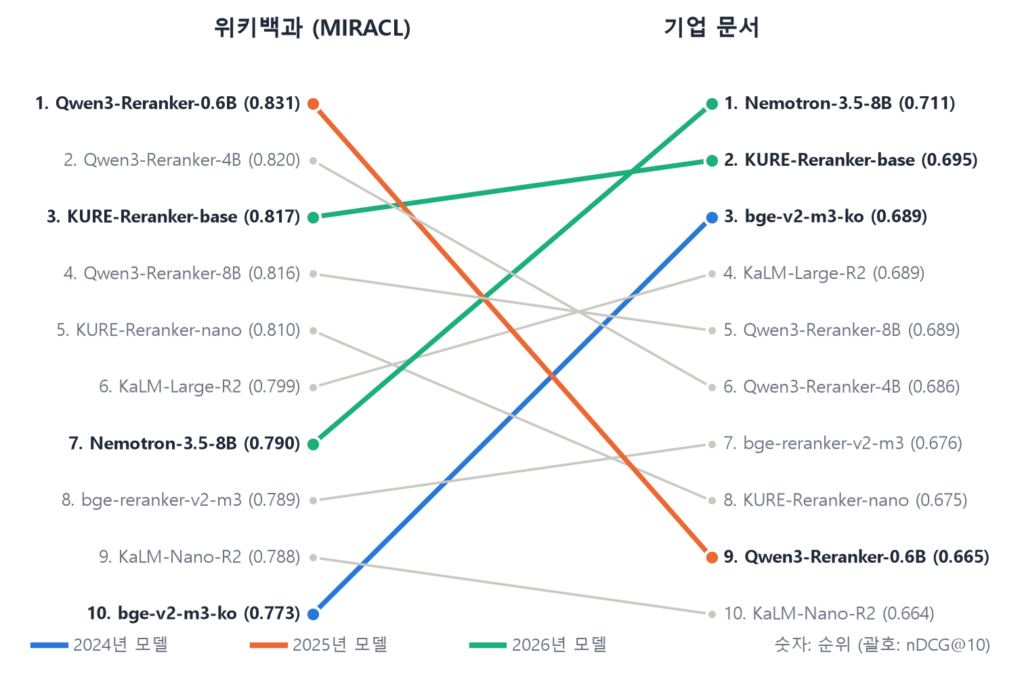
[그림 3] 위키백과와 기업 문서에서의 모델 순위 변화
선행 연구와 같은 방향: 재순위화 방법 22개를 비교한 연구에서도, 공개 벤치마크에서 잘하던 방법들이 새로 만든 평가 데이터에서는 성능이 5~15% 떨어졌고, 그 정도도 모델마다 달랐다[5].
공개 벤치마크 순위는 참고만 하고, 내 데이터로 다시 재야 한다.
6.6 크다고 좋지 않다
같은 모델을 크기만 달리해도 큰 쪽이 꼭 좋지는 않았다. Qwen3-Reranker를 0.6B·4B·8B 세 크기로 비교하면, 위키백과에서는 가장 작은 0.6B가 4B·8B보다 좋았다.
다른 모델끼리 비교해도 마찬가지다. 기업 문서에서 Qwen3-Reranker-8B와 훨씬 작은 bge-reranker-v2-m3-ko(0.57B)는 nDCG@10이 0.689로 같았는데, 8B 쪽이 처리 시간은 26배, GPU 메모리는 13배였다(그림 4).
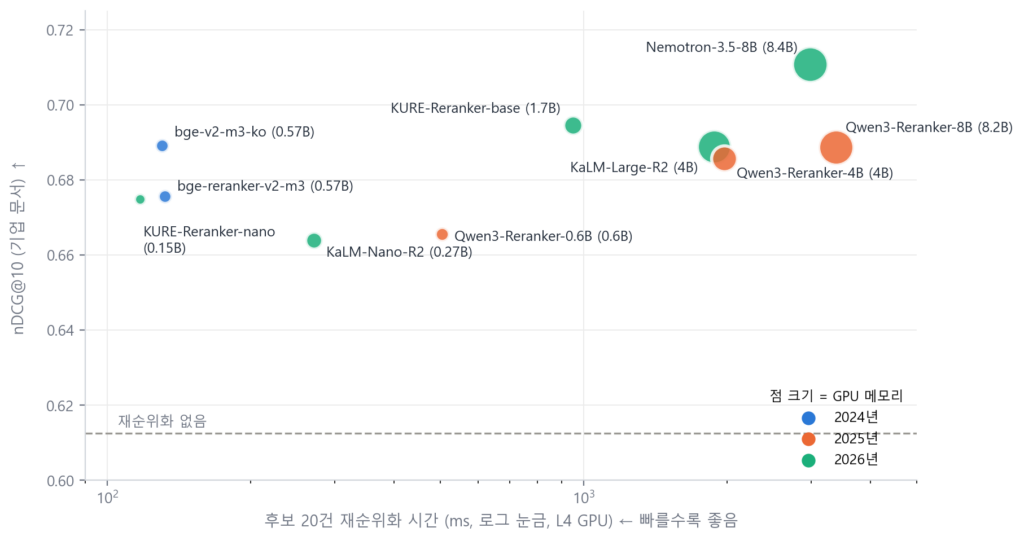
[그림 4] 정확도와 처리 시간 (기업 문서, 점 크기는 GPU 메모리)
7. 마치며
실험 결과를 바탕으로, 상황에 따라 고를 만한 재순위화 구성을 표 8에 정리했다.
| 상황 | 추천 | 근거 |
| GPU가 작거나 응답이 빨라야 함 | bge-reranker-v2-m3-ko 또는 KURE-Reranker-nano | 0.1초대, GPU 1.3GB 이하. 1위 정답률 +12~16%p |
| 정확도와 속도의 균형 | KURE-Reranker-base | 기업 문서 2위, 1위 정답률 최고, 약 1초 |
| 정확도 최우선, GPU 여유 | Nemotron-3.5-Rerank-8B | 기업 문서 1위, bge-reranker-v2-m3 대비 nDCG@10 +0.035 |
| 1차 검색 | 하이브리드 검색(BM25 + 한국어 임베딩 KURE-v1) | 1차 검색만으로 가장 좋음(후보 20건 안 정답 96.1%, nDCG@10 0.659) |
| 후보 수 | 10~20건 | 20건까지는 오르고, 20건 → 50건은 +0.01 안팎 |
[표 8] 상황별 재순위화 구성 추천 (실험문서 기준)
표 8은 이 글의 실험 결과에서 나온 추천이다. 실제로 재순위화를 도입할 때 챙길 점을 정리하면 다음과 같다.
- 1차 검색부터 확인한다. 정답이 후보 안에 들어오는지부터 본다. 이 실험에서는 단어 일치와 임베딩을 섞은 하이브리드 검색이 가장 좋았다.
- 자기 데이터로 고른다. 공개 벤치마크는 참고만 하고 내 문서로 만든 질문으로 비교한다.
- 후보는 10~20건. 20건을 넘기면 시간만 늘고 효과는 미미하다.
- 한국어 모델부터 시험한다. 한국어 문서라면 한국어 임베딩과 재순위화 모델이 먼저다.
- 정확도만 보지 않는다. 처리 시간, GPU 메모리, 라이선스를 함께 본다.
재순위화는 1차 검색이 가져온 후보의 순서를 바로잡아, 답변 LLM에 정답 문단을 앞세워 주는 단계다. 규칙·점수 기반에서 크로스 인코더, LLM 기반으로 발전해 왔고, 이번 실험에서도 어떤 모델을 붙이든 효과가 있었다. 다만 좋은 결과는 모델 하나로 정해지지 않았다.
정답을 후보에 넣는 1차 검색, 알맞은 후보 수, 응답 속도와 GPU에 맞는 모델 크기, 그리고 실제로 다룰 데이터가 함께 맞아야 했다. 멀티모달과 추론형처럼 새로운 흐름도 계속 나오는 만큼, 이 글이 각자의 RAG 시스템에 맞는 재순위화 구성을 찾는 출발점이 되길 바란다.
참고 자료
[1] Allganize, RAG-Evaluation-Dataset-KO (Hugging Face) https://huggingface.co/datasets/allganize/RAG-Evaluation-Dataset-KO
[2] Zhang 외, MIRACL: A Multilingual Retrieval Dataset Covering 18 Diverse Languages (TACL 2023) https://aclanthology.org/2023.tacl-1.63/
[3] BAAI, bge-reranker-v2-m3 (Hugging Face) https://huggingface.co/BAAI/bge-reranker-v2-m3
[4] Järvelin, Kekäläinen, Cumulated Gain-Based Evaluation of IR Techniques (ACM TOIS, 2002) https://doi.org/10.1145/582415.582418
[5] Abdallah 외, How Good are LLM-based Rerankers? An Empirical Analysis of State-of-the-Art Reranking Models (Findings of EMNLP 2025) https://arxiv.org/abs/2508.16757